Anthropic启动Cyber Mission,向电网和水务提供Claude
2026-10-08
CIDP向电网和水务等运营方提供Claude与驻场工程师,OSS Scanner为开源项目提供漏洞扫描。
聚焦开放权重、开源代码、许可证、开放标准,以及开放与封闭策略对生态的影响。
2026-10-08
CIDP向电网和水务等运营方提供Claude与驻场工程师,OSS Scanner为开源项目提供漏洞扫描。
2026-10-10

Deno runtime 获一年维护、Deploy 六个月后关闭;团队将把 celld 的分布式状态机制并入 workerd,完整兼容和多租户控制面仍待交付。
2026-10-24
开发者分发为它打开企业销售入口;真正要卖的是团队控制面、私有部署与支持,而克隆量、收入和数据边界仍待客户验证。
2026-10-05
GitHub 用 219 个真实 PR 同时衡量已知问题召回与新增发现质量;公开题库更接近生产,也让 Claude 裁判成为新的变量。
2026-10-23
Apache 2.0权重、三种精度与开源工具链让企业真正能自托管;最低近294GB检查点和多卡配置,也把成本、安全更新与监控责任交给部署者。
2026-09-20
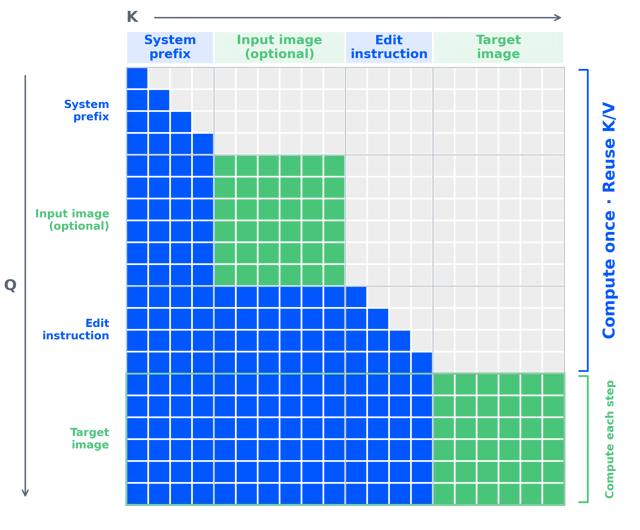
7B 视觉生成模块统一文生图、编辑和最多十张参考图;全套 BF16 权重约 33GB,研究许可只放行非商业用途。
2026-09-22
五年让 34 亿人用母语和语音使用 AI 仍只是共同目标;联盟已列出数据、评测、工具与安全四条线,成员承诺、资金和治理规则尚待敲定。
2026-09-17
它冻结模型与外部依赖,只在危险动作前运行新代码,把一次事故变成可进 CI 的回归测试。
2026-10-10
5 到 6 个工具时三条指令全对,25 个工具时全错,倒序后对两条。端侧小模型要先测真实目录,再看跑分。
2026-09-18
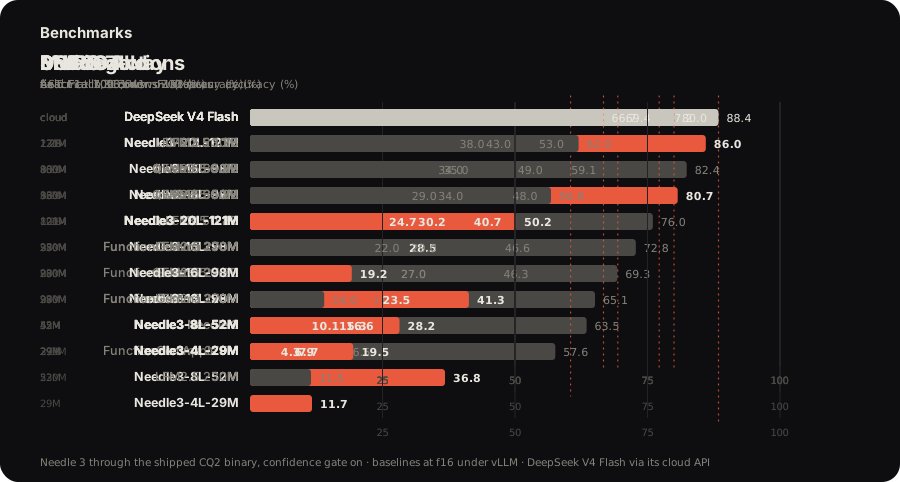
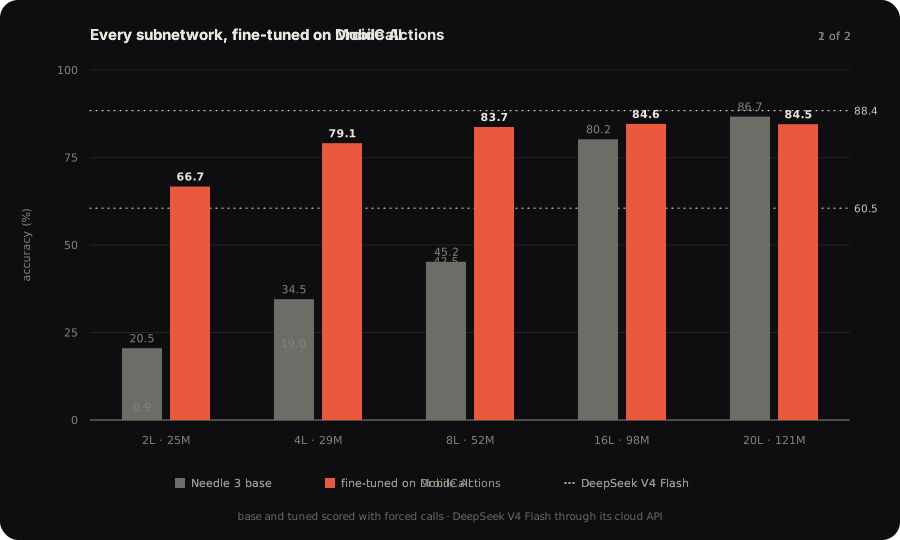
20 层版在手机指令测试上接近 DeepSeek V4 Flash,换到多步调用和抽取就落后;实发文件也比宣传的 29 MB 大。
2026-09-19
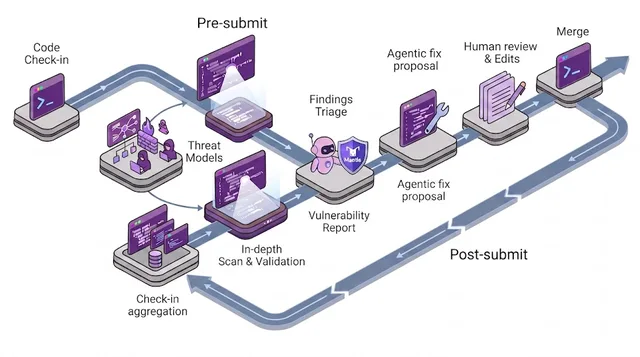
生成式扫描先找问题,AST、调用图和规则再证明路径可达;Google 未披露召回率、样本量和修复采纳率。
2026-09-21
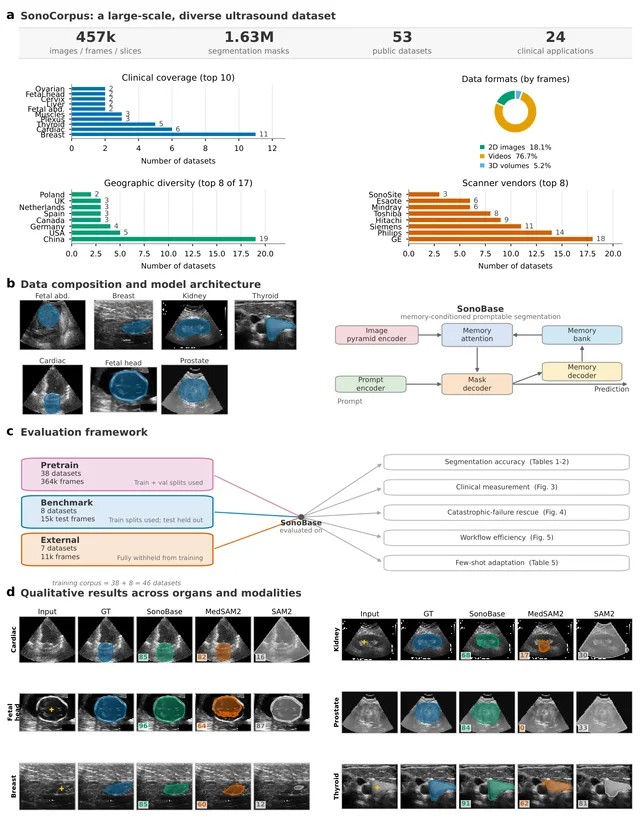
53 个超声数据集没有被重新分发;来源、切分、哈希、评测记录与完整训练状态把复核入口留给了外部研究者。
2026-09-17
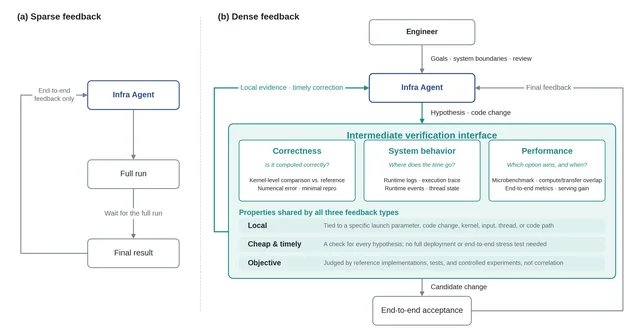
智谱公布的 13 天演进曲线显示吞吐升至初始基线的 3.22 倍;公开 PR 还原了一次长上下文精度修复。
2026-09-14

5.5 亿美元融资背后,Temporal 记录工作流事件并从断点恢复;它保存执行进度,却仍把外部动作幂等和代码版本责任留给开发者。
2026-09-11
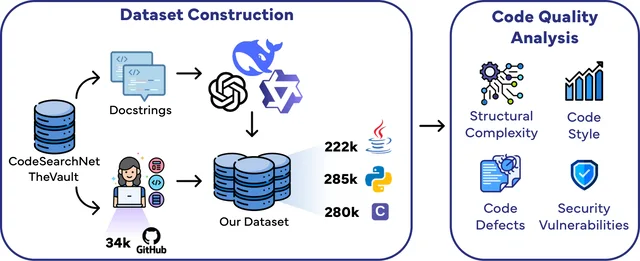
它把已知易触发缺陷的函数做成可复算压力测试,却不能替代编译、功能测试与漏洞验证。
2026-09-10
Nemotron 3 Ultra 以三个版本生成、校验和改写证明,官方得 30 分;权重、数据和代码开放,却没有把算力门槛一并降下来。
2026-09-11
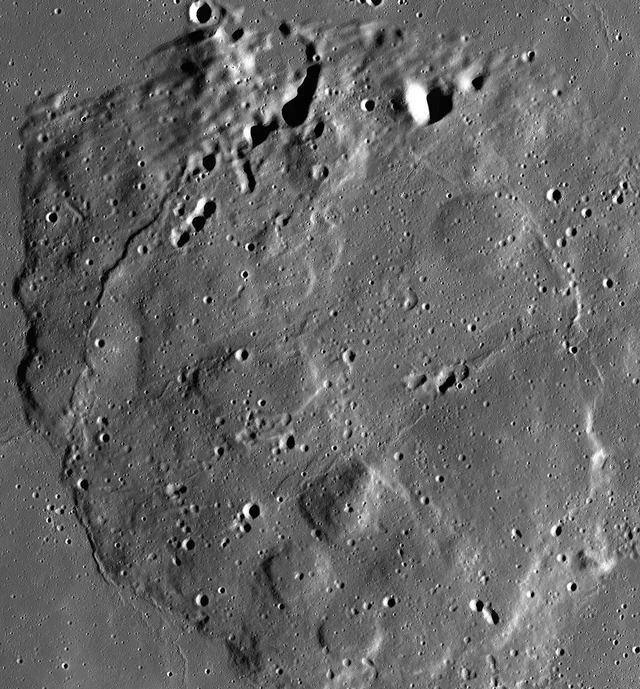
模型用分离的米级与百米级轨道图块预训练,并随代码、数据和四项基准开放;性能优势集中在冰稳定性适宜度回归,而非实测冰发现。
2026-09-04
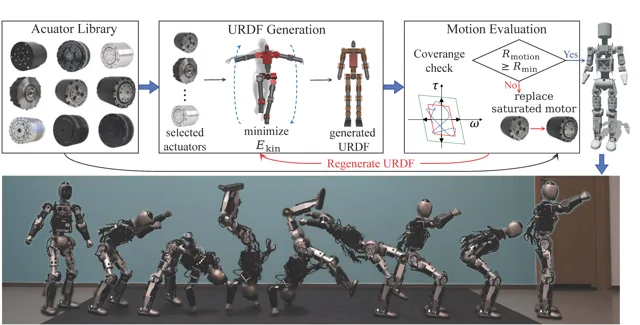
论文在统一仿真基准上取得更高动作跟踪成功率,实机完成多类动作;当前公开工件仍不足以让外部团队复现。
2026-09-03

规则是写给 LLM 裁判的自然语言条件,不是确定性程序;数据能诊断前沿模型弱点,但不代表日常翻译质量分布。
2026-09-07
旗舰模型采用稀疏 MoE、支持 256K 上下文;低价来自限时五折,端侧开源版的 1M 上下文仍要支付 KV cache 内存成本。
2026-09-01
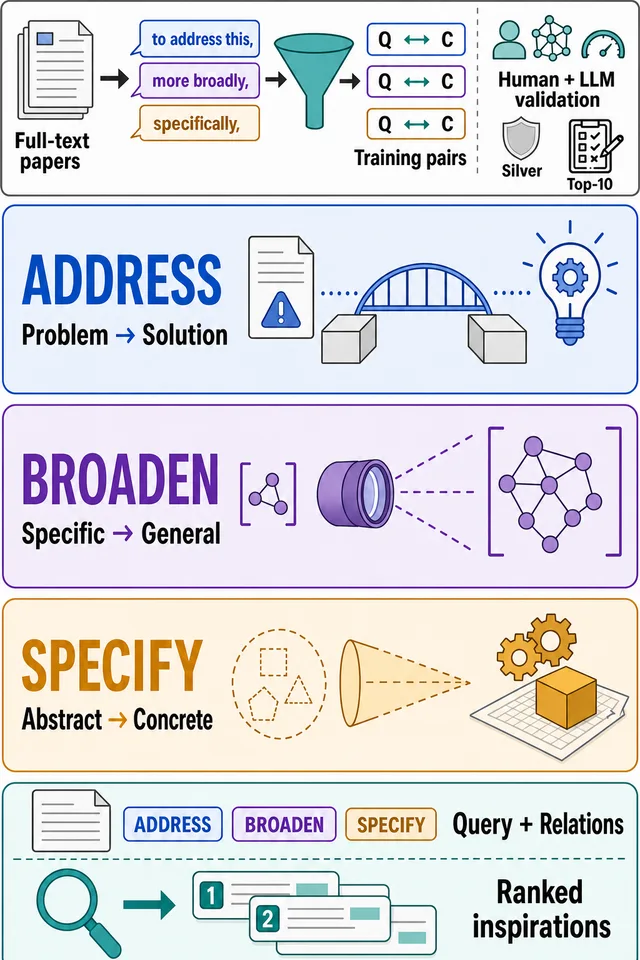
新基准用论文连接词构造 302 万组训练与评测样本,关系特定微调显著提升检索,但尚未验证能否产出更好的科研假设。
2026-08-31

Hy4 用稀疏注意力等技术降低长上下文开销。腾讯称模型参与优化推理系统后吞吐提升31.8%,但未说明比较基线。
2026-08-27

谈判尚处早期,收入计算方式与用量审计仍待商定。K3 许可证要求大型服务商另签商业协议,美国监管也可能影响合作。
2026-08-27

媒体对交易已同意还是仍在谈判说法不一,双方均未证实。若收购完成,Hugging Face 对其他芯片厂商的支持将成为关注点。
2026-08-26
这款模型提前预览 Qwen4 架构。Qwen 自报训练成本约为 Qwen3.7-Plus 的 1/9,部署仍需多卡,部分商用场景须另获许可。
2026-08-24

框架负责保存上下文、调用工具和执行审批。同一模型在ARC-AGI-3上的对照实验显示,调整推理保留与上下文压缩,也会明显改变成绩和消耗。
2026-08-14
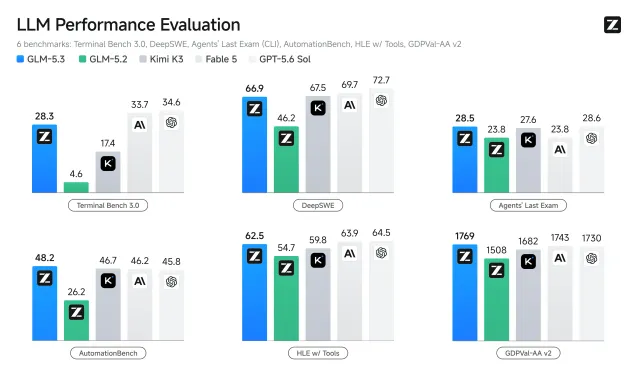
GLM-5.3 沿用前代基础模型,官方称后训练显著提高了漏洞利用成绩。Z.ai 将权重开放推迟两周,并要求敏感网络安全功能的用户先通过审核。
2026-08-13

X 扩大公开推荐系统代码,并让符合条件的用户下载账号和帖子的排序标签。公开模型可用于实验,但无法完整重现线上时间线,Grok 违规判定环节仍未开放。
2026-08-12

Ai4 对谈中,吴恩达强调开放模型的竞争价值,Hinton 担心滥用风险,李飞飞主张按对象和用途区分开放程度。
2026-08-12

Qwen 首次开放 Max 级模型权重。2.4T 模型需经第三方 4-bit 量化才能装入部分高端单节点,量化后的编码与 Agent 能力仍待验证。
2026-08-12
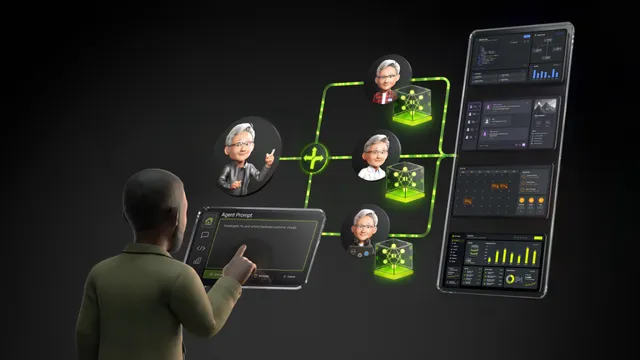
Lightning 执行高频任务,开源 Switchyard 按请求选择模型。合作方报告降本效果,但收益取决于任务、模型池与比较基线。
2026-08-10

Motif-3 以 MIT 许可开放权重,自测在两项 Agent 基准中领先对比组。模型正参加韩国国家 AI 项目评估,实际任务表现与推理成本仍待检验。
2026-08-10
Glimmer 以 Apache 2.0 许可开放,提供面向消费级 GPU 的量化版本和推理加速工具。部分 Agent 自测领先同类模型,实际工作流仍需验证。
2026-08-06

WeatherNext 气旋预测论文发表于 Nature,三天预报精度平均相当此前两天水平。三个版本的代码和权重公开,仍需气象机构判断并发布预警。
2026-08-05

Cloudflare OS 以 Apache 2.0 开源,将应用隔离、资源授权和代码修改结合。用户可创建自己的应用副本,企业仍需配置权限并接入内部系统。
2026-08-04

两家公司发布首个高带宽闪存 HBF 标准,最高容量 512GB,带宽约 0.4–3 TB/s。它拟为 HBM 补充容量,性能证据仍以模拟为主,量产时间尚未确定。
2026-08-04

社区围绕 V4 Flash 测试量化、推测解码和多种硬件。部分配置已能本地运行,但内存和长上下文延迟仍有门槛,低价矿卡案例运行的是另一款模型。
2026-08-03
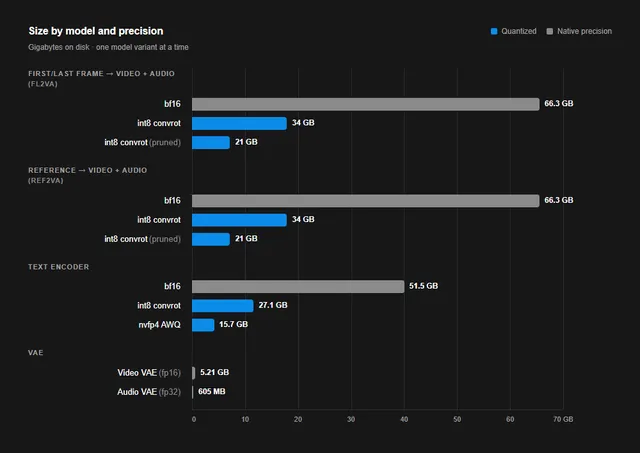
H3 在视频编辑盲评中排名第一,基础生成模型已开放权重。ComfyUI 降低了本地运行门槛,但预处理和 2K 再生模块仍通过 API 提供,商用也有许可条件。
2026-08-03

Qwen3.8-Max API 已上线,权重计划下周开放。官方展示了持续编码、论文复现和竞赛任务,但长任务自主程度与多项自建评测仍缺独立验证。
2026-08-02

LongCat-Flash-Lite-Sparse 总参数 690 亿、激活约 30 亿,采用稀疏注意力并支持百万 token 上下文。美团自测显示编程和工具任务改善,真实部署效果仍需验证。
2026-07-31
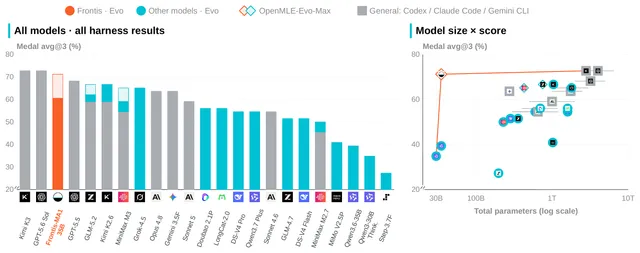
Frontis-MA1 将程序生成、改进、调试和重组纳入训练,并开放模型与实验工具。论文区分后训练和搜索系统收益,目前验证限于机器学习工程,未宣称实现通用递归自我改进。
2026-07-28

Fish Audio 以 22 人团队做到 2100 万美元年经常性收入,计划扩展语音产品;社区上传声音的授权争议仍未解决。
2026-07-27

Amodei回应Nvidia牵头的公开信,称Anthropic未主张全面禁止开放权重模型,同时要求对能力足够强的模型开展强制安全测试。
2026-07-27
Kimi K3完整权重已发布,多项评测表现靠前。自行部署仍需较大硬件投入,使用成本和回答可靠性也要分别衡量。
2026-07-26

Upstage开放Solar Open 2权重,采用250B总参数、15B活跃参数,支持百万token上下文,计划用于Daum等服务。
2026-07-10
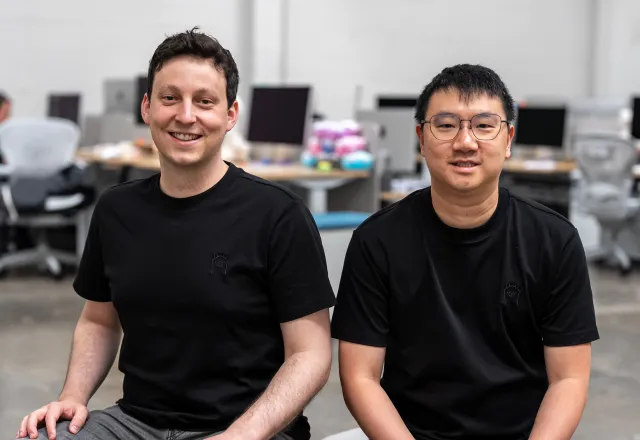
Ollama 宣布完成 B 轮融资,继续简化开放模型的本地运行,并扩展付费云服务。团队需要兼顾云业务、免费工具维护与社区信任。
2026-07-01

Brain2Qwerty v2 从志愿者打字时的脑磁信号还原英文句子,结合神经网络与语言模型提高词准确率,距离患者使用仍有硬件和任务适配障碍。
2026-06-29

GLM-5.2 支持百万 token 上下文,在部分长程编程测试中接近 Opus 4.8,另一些任务仍有明显差距。较低报价增加了吸引力,实际任务成本还需测量。
2026-07-01

开源 CUDA 兼容层 ZLUDA 发布 v6,改善 Blender 和 Windows 支持。开发者同时披露商业资助已结束,项目回到业余维护状态。
2026-07-21

Kimi 团队称请求量超出预期,暂停面向个人用户的新订阅,优先保障已付费用户。权重开放可以增加部署渠道,但算力和运维仍有成本。
2026-07-20
Kimi K3 已开放在线服务,完整权重计划于 7 月 27 日前发布。新模型拥有 2.8 万亿参数,前端编程表现突出,整体能力仍有差距。
2026-07-14

五家公司的合作细节尚未公开。MCP 已由开放项目维护,新方案能否减少企业集成工作,要看兼容性和实际代码。
2026-07-14

高盛从定价、成本和财务实力比较中国模型公司,看好智谱与 DeepSeek 的竞争地位。低价有助于普及,可靠性、算力和市场准入仍影响商业化。
2026-07-11

同一模型放进不同运行框架,编程测试成绩也会变化。文章从工具、上下文、记忆和纠错等六方面分析,为什么比较总分还不够。
2026-07-10
GitHub 将 Kimi K2.7 Code 扩展至 Business 和 Enterprise,默认关闭、由 Azure 托管。企业还需结合自己的任务测试成本、效果和模型行为。
2026-07-10

Muse Spark 1.1 每百万输入、输出 token 分别收费 1.25 和 4.25 美元。Meta 同时兼容两家主流 API 格式,但预览地区、迁移适配和实测表现仍有限制。
2026-07-09
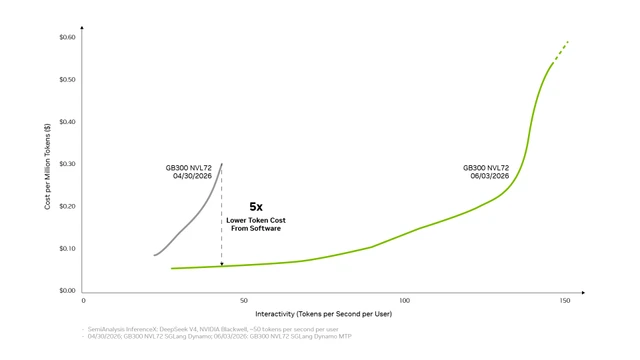
NVIDIA 援引测试称,Blackwell 上的软件优化显著降低了 DeepSeek V4 推理成本。吞吐提升来自内核、调度和错误修复,效果仍受部署条件限制。
2026-07-08

美国众议院两委员会调查Anysphere和Airbnb使用中国AI模型的情况。联邦采购限制是讨论方向,但已公开模型权重的传播难以全面阻断。
2026-07-08

路透社援引消息人士称,中国商务部与阿里、字节和智谱讨论先进模型海外访问及投资限制,尚无草案或时间表,适用范围仍不明确。
2026-07-01
Together AI 完成 8 亿美元 C 轮融资,估值升至 83 亿美元。公司将扩充开源模型训练和推理服务,并获得超过 500 兆瓦的算力建设承诺。
2026-07-07

OpenRouter美国企业样本中,中国模型自2月起用量占比每周超30%、峰值46%。价格推动部分企业迁移,平台数据不代表整个市场。
2026-06-30

LongCat-2.0 总参数 1.6 万亿,美团称全流程使用国产算力。预览版已跻身 OpenRouter 调用量前三,官方成绩仍待独立验证。
2026-06-30

Godot 宣布收紧贡献政策,禁止自主Agent提交与大段AI生成代码,保留有限辅助用途。新贡献者提交功能前须获许可,维护者希望减少审查积压。
2026-06-29
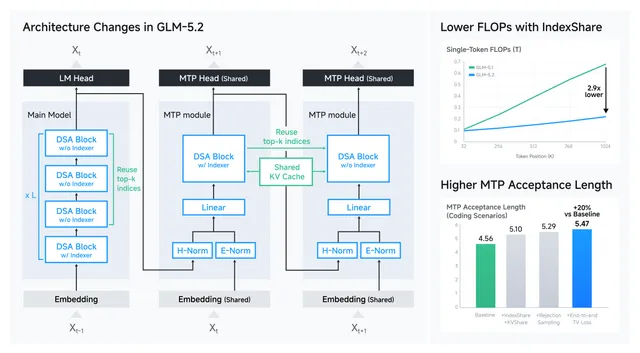
GLM-5.2 的推理与编程表现、较低报价和开放权重获得关注。同期美国限制部分前沿模型访问,但政策对开发者选择和市场份额的影响尚难量化。
2026-06-19

Kempf 创办的 Kyber 获 500 万美元融资,将视频、传感器与控制信号接入同一套传输工具,面向机器人等设备,提供开源 SDK 和商业授权。
2026-06-26
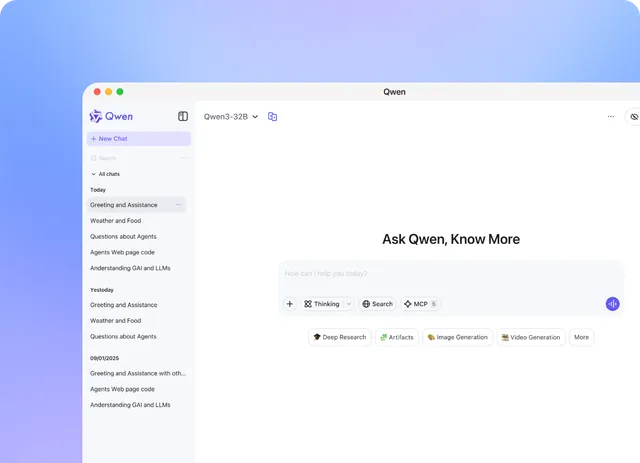
Qwen 3.7 以在线服务提供,开源社区担忧后续开放策略。人员变动与商业化压力值得关注,但团队解散及永久停止开源的传言尚未获证实。
2026-06-26

Apertus 于 2025 年发布,提供 80 亿和 700 亿参数版本,并公开代码与数据流程。约四成预训练数据为非英语内容,支持外部审查与后续开发。
2026-06-25
Ling/Ring 2.6 技术报告介绍混合注意力、压缩冗余推理及强化学习方法。两个万亿参数模型分别面向即时响应和深度推理,权重采用 MIT 许可。
2026-06-25

Patch the Planet 首周覆盖 19 个开源项目,已有 37 个补丁合并。工程师负责核验、修补和披露,并留下可复用的安全工具。
2026-06-25
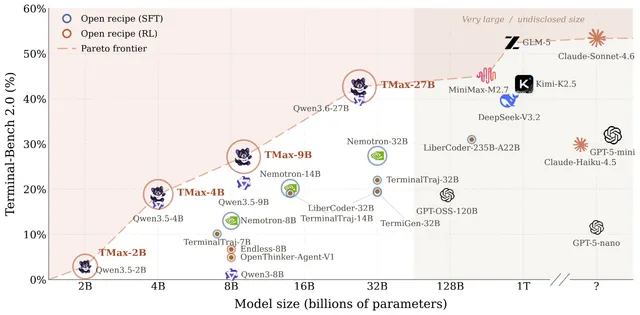
TMax 开放 14,600 个终端训练环境和强化学习方案,9B 模型在 Terminal-Bench 2.0 达 27.2%,并在其他工具设置中获得提升。
2026-06-24

报道指 Baseten 正洽谈新一轮融资,估值较 1 月的 50 亿美元最高增长 160%。公司为企业部署开放模型;约 6 亿美元年化经常性收入来自外部估算,融资尚未确认完成。
2026-06-23
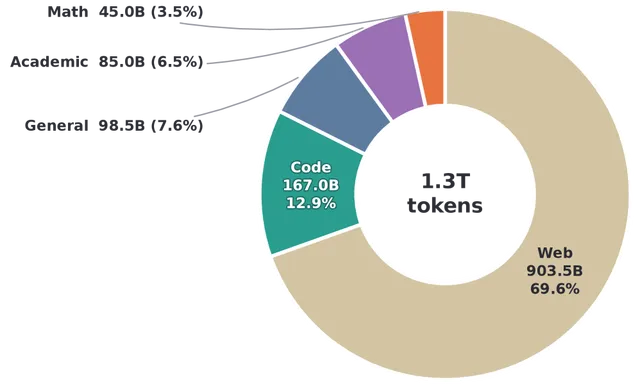
Sumi 在约 1.5 万亿 token 上从零训练,开放权重、检查点和训练配方。它在部分知识与代码测试中领先对照模型,但常识推理和自我纠错仍有不足。
2026-06-15
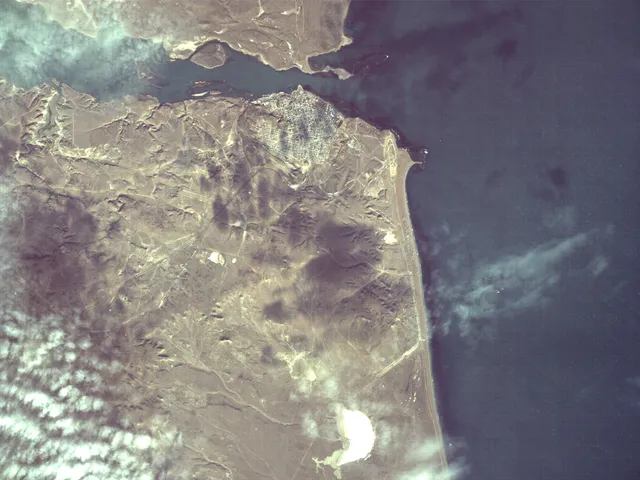
Loft Orbital 的 YAM-9 已在轨运行 Gemma 3,分类新拍图像并生成描述。NAVI-Orbital 希望先下传摘要、再选择完整影像,后续仍需检验持续运行表现。
2026-06-08
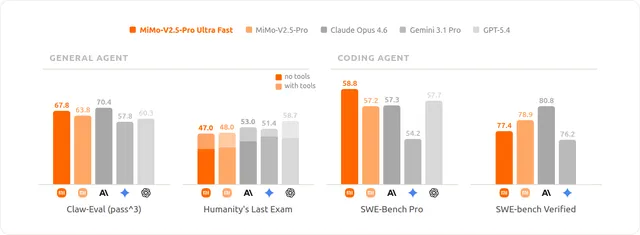
MiMo 与 TileRT 结合量化、推测解码和 GPU 调度,官方称生成速度约为标准版的 10 倍,试用 API 价格为 3 倍。
2026-06-20

Fable 5 因出口管制下线后,智谱推出 GLM-5.2 并开放权重。模型可用性成为竞争因素,但股价上涨和产品发布尚不能证明用户已大规模迁移。
2026-06-12
Kimi K2.7-Code 开放权重。公司自建编程测试得分由 50.9 升至 62.0,并称平均思考 Token 减少约 30%。
代码审查 Agent 不只要多抓 bug:ReviewBench 把噪声写进评测
2026-10-05