8 月 26 日,阿里 Qwen 团队开放了 Qwen3.8-Flash-Next 的权重,并将其定位为 Qwen4 架构的"提前预览"。官方博客明确说,它扮演的角色与当年的 Qwen3-Next 之于 Qwen3.5 相同——那次引入的 Gated DeltaNet 加 Gated Attention 混合架构,后来被 Qwen3.5 到 Qwen3.8 全系沿用。这一次,Qwen 把下一代架构在注意力、残差、嵌入、优化器四个方向上的改动提前交给社区,希望通过稀疏激活和确定性查找表,降低处理每个 token 的成本。
每个 token 激活 6B 参数,部署仍需要多卡
Qwen3.8-Flash-Next 是一个多模态混合专家(MoE)模型:125B 主干,外加 51B 的 N-gram 嵌入表和 4B 的多 token 预测(MTP)模块,磁盘上约 180B 参数,但每个 token 只激活 6B。作为对照,上一代 Qwen3.7-Plus 是 397B 总参数、17B 激活,Flash-Next 的激活量只有它的约三分之一。
每个 token 激活的参数较少,可以减少矩阵乘法计算量,但全部权重仍需存储,不能因此把它当作轻量模型。FP8 checkpoint 有 172.78 GiB,BF16 是 335.28 GiB;按 vLLM 的部署配方,FP8 在 GB300 上至少需要 TP2、推荐 TP4,8×H200 节点要用 TEP8。自托管意味着多卡节点,而不是单张消费级 GPU。
从注意力到优化器,四项改动降低计算与访存开销
官方把改动归结为四个方面。注意力的核心是 GDN 与 QSA 的混合:48 层里每 4 层为一组,其中 3 层用 Gated DeltaNet(GDN)——一种线性注意力,把历史信息持续压缩进一个固定大小的循环状态;第 4 层用 Qwen Sparse Attention(QSA),由轻量 indexer 先把序列聚成 micro-block、在块级别估计重要性,再只对选中的区域做全局注意力。用官方的话说,GDN 负责高效地"记",QSA 负责精确地"取";QSA 的预算被设为 512 个块、2048 token。
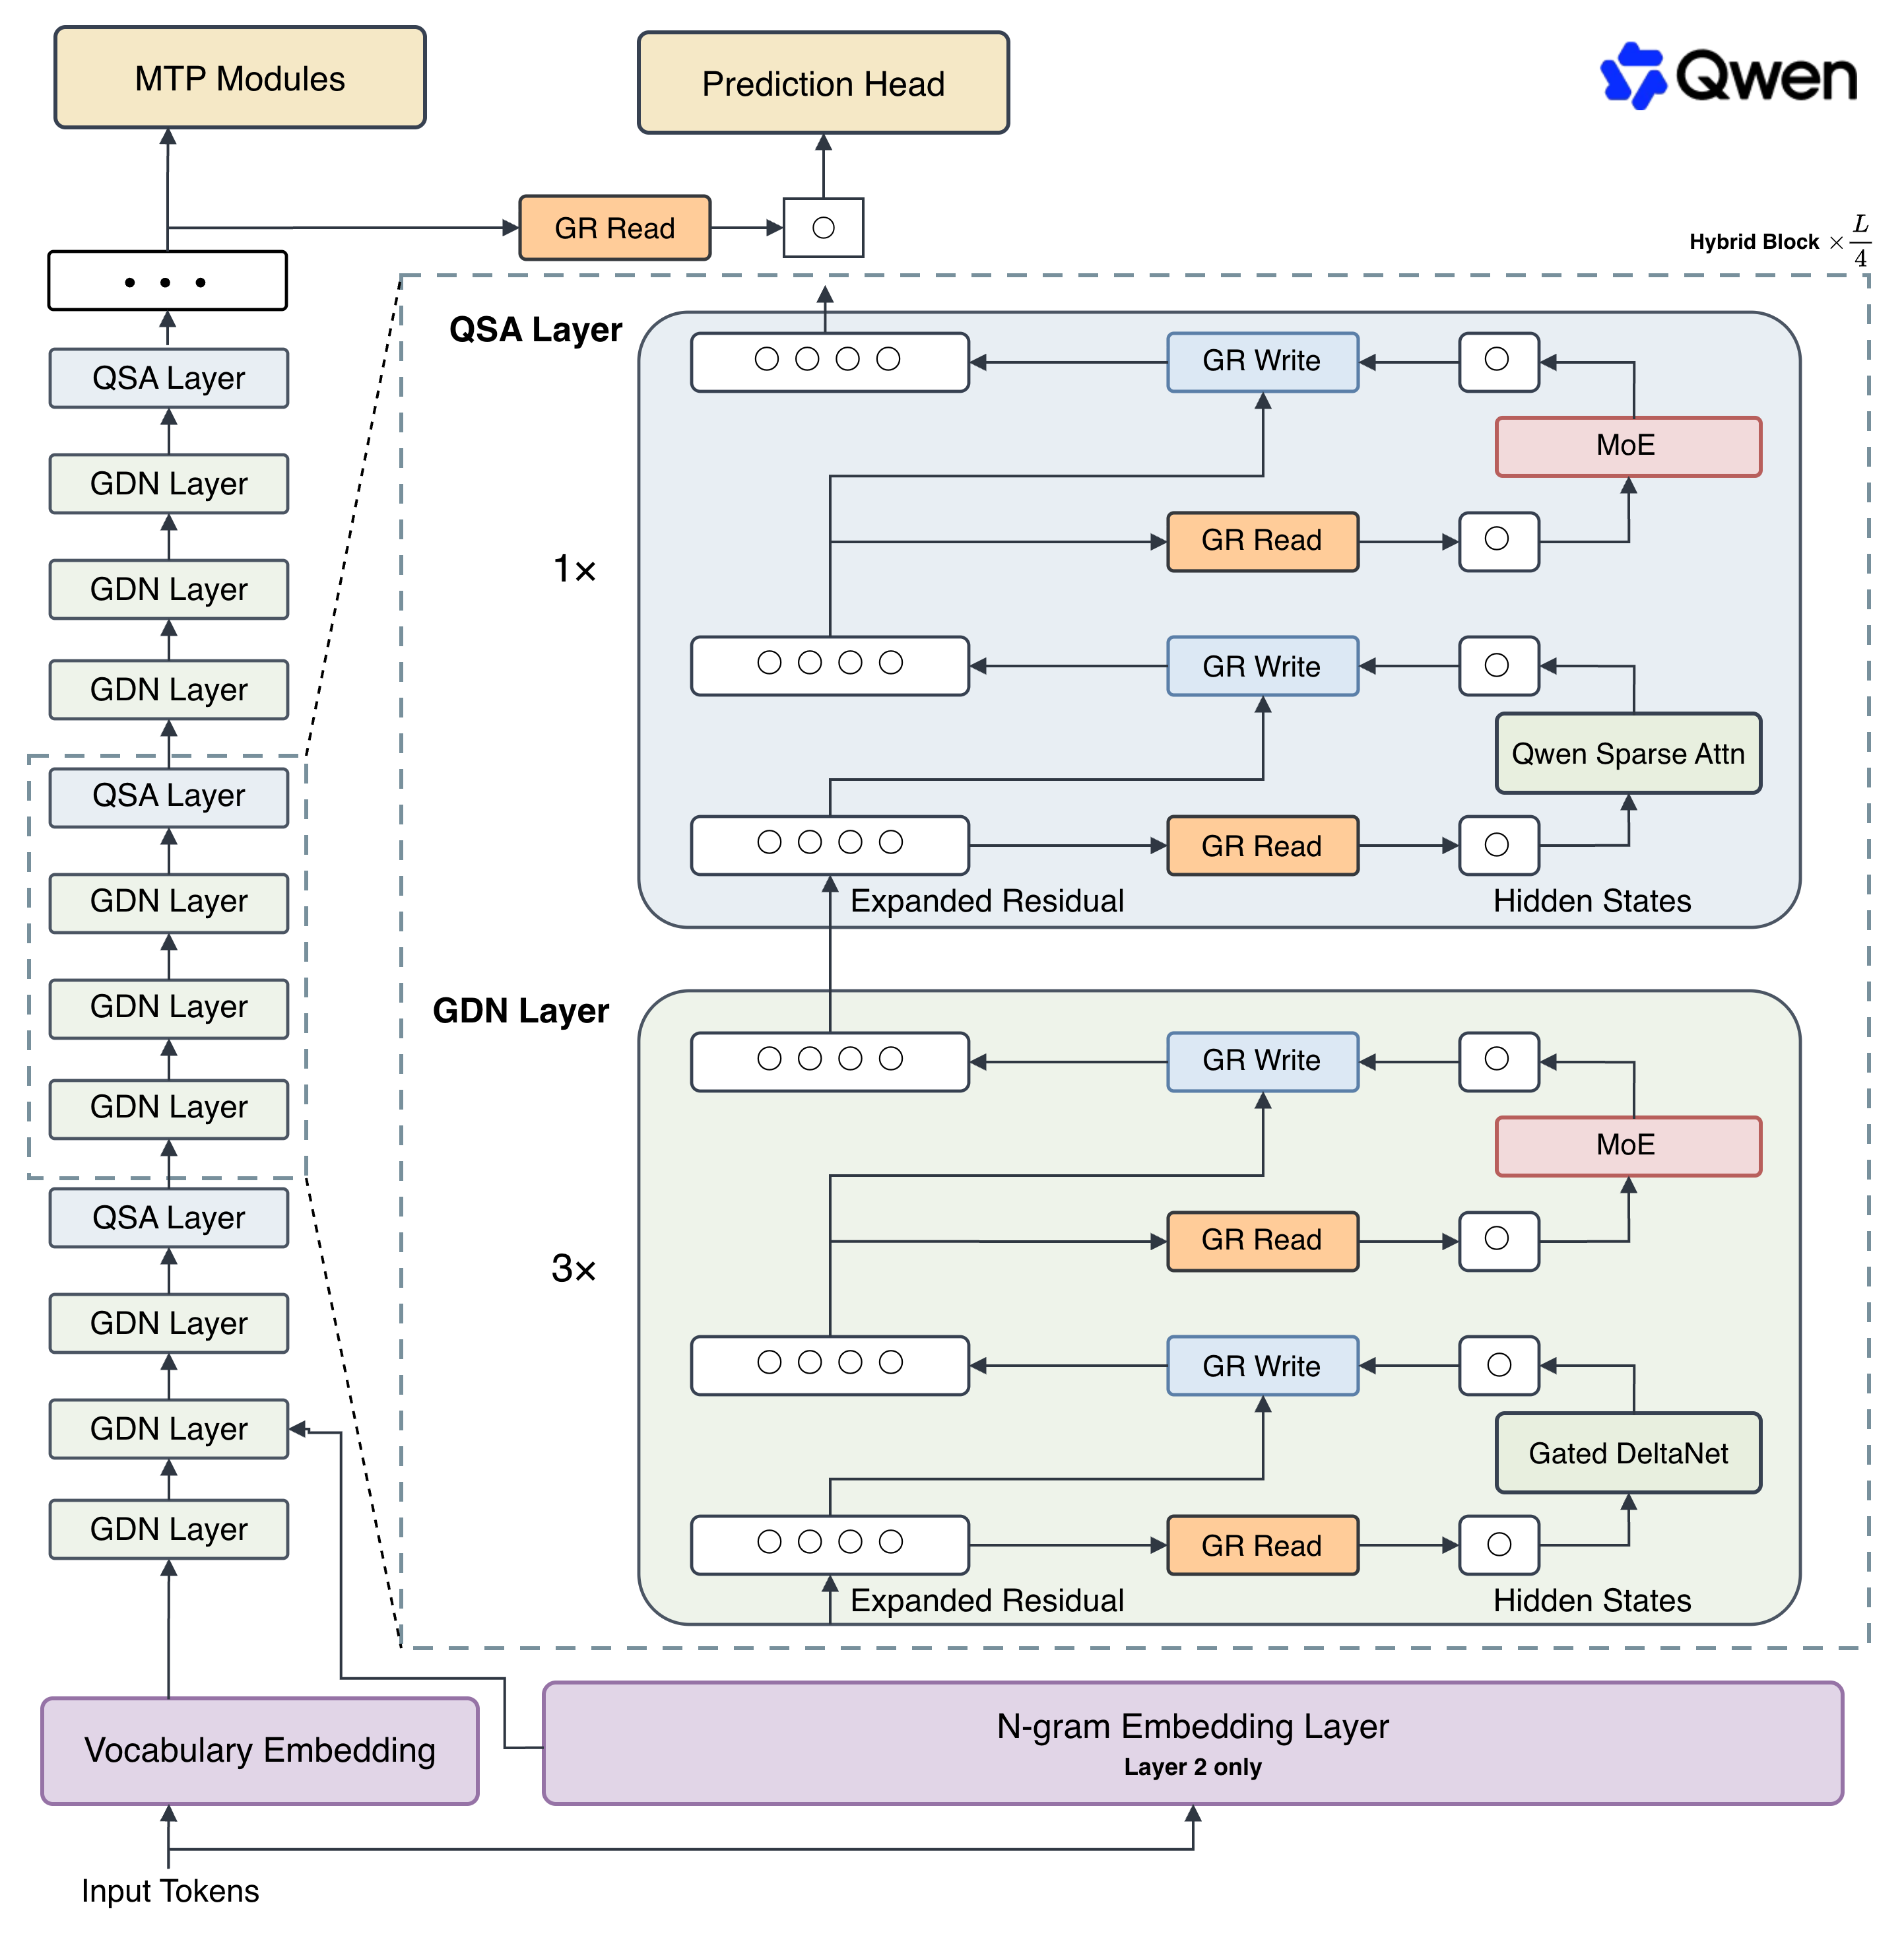
残差方面,Gated Residual 把单一残差流扩成 4 条并行分支,用逐元素读门和每分支标量写门动态控制读写,瓶颈秩 320,残差状态还支持 FP8 存储以进一步减少内存访问。嵌入方面,N-gram Embedding 在第 2 层放了一张 2000 万条目的二元/三元短语查找表,用局部上下文做确定性查表;因为查表位置可以预先确定,这 51B 参数能放在主机内存、用异步预取与计算重叠,不必常驻 GPU 显存。优化方面,主优化器换成 Muon,与 AdamW 分工,并重拟合了 scaling law——团队还发现大批量训练常用的 batch-size warmup 不再必要,直接以目标 batch 起步反而省掉 18.8% 的优化步数。
训练成本自报降至 1/9,评测设置影响横向比较
官方宣称训练成本约为 Qwen3.7-Plus 的 1/9,同时在编码和办公任务上表现更好——这句话的每一半都来自 Qwen 自己的测量,尚无第三方复现。
看自报的基准分数,领先集中在 agentic 编码和办公任务:DeepSWE 1.1 得 58.7(Qwen3.7-Plus 为 16.5)、SWE-bench Pro 62.5、CoWorkBench 73.9(DeepSeek-V4-Flash 为 45.1)、JobBench 55.7(Qwen3.7-Plus 为 27.6,接近翻倍)、LiveCodeBench v6 91.9、GPQA Diamond 91.7。但它并非处处领先:多学科推理 HLE 得 35.9,落后 Claude Opus 4.6 (Max) 的 40.0;仓库级代码生成 NL2Repo-Bench 48.1,落后 DeepSeek-V4-Flash 的 54.2。
官方也披露了几项评测设置:DeepSWE 1.1 取的是两个 harness(Claude Code 与 mini-SWE-agent)里的最高分;SWE-bench Pro 修正了部分题目并据此重评了所有基线;CoWorkBench 是内部基准;HLE 用 GPT-4o 而非基准默认 grader 评判。这些做法本身透明,但意味着分数不能与其他模型在原始基准上的报告值直接并排比较。
沿用 Next 发布方式,提前公开下一代架构设计
"Next" 后缀对应的是一次架构预览。官方博客写明,Qwen3-Next 引入的 GDN + Gated Attention 混合架构,后来被 Qwen3.5、Qwen3.6、Qwen3.7、Qwen3.8 全系采用。这一次,Flash-Next 用 QSA 替换了作为"检索"那一半的 Gated Attention,作为 Qwen4 的架构先导。通过这款模型,Qwen 将尚未定型的下一代设计提前交给社区检视。上一款 Next 的架构随后被全系采用,这次则继续沿用预览方式。
对外提供模型服务或 AI 助手,须单独取得许可
与 Qwen3.8-27B 使用 Apache-2.0 不同,Qwen3.8-Flash-Next 采用 Qwen Community License 1.0。许可证正文允许自由使用、复制、修改、分发、托管和微调,但附加两条商业条件:商业产品或服务若月活超 1 亿或月营收超 2000 万美元,必须在用户界面显著展示模型名;若被用于 Model as a Service 或 AI 工作助手(AI Work Assistant)业务,则需在商用前单独向 Qwen 取得许可,仅限内部使用、不向第三方暴露能力的情况除外。
生产版本 Qwen3.8-Flash 通过 QwenCloud 提供,定价输入 $0.16、输出 $0.47 每百万 token,约为旗舰 Qwen3.8-Max($2.00 / $6.00)的 1/12。官方强调的长上下文加速——QSA kernel 在 1M token 下 prefill 7.6×、decode 4.9×,90% 前缀缓存命中率时 prefill 吞吐是 Qwen3.7-Plus 的 8.6×——同样是厂商自报;SGLang 与 vLLM 的配方里还出现过 10.2× 与 6.6× 的另一组数字,这些数字对应的设置需分别核对,不能直接视为同一个可复现结果。
权重已经公开,下一步需要第三方验证:能否复现 1/9 的训练成本,以及在相同测试设置下得到接近的基准分数。这些结果将帮助判断,新架构在实际训练和部署中能节省多少成本。