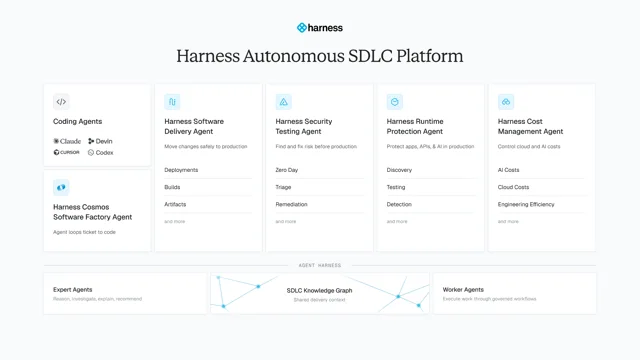
8 月 19 日,OpenAI 发布开发者博客《Codex as a platform》,把驱动 Codex 的执行框架 Harness 明确作为开源平台对外推出:Codex CLI、app-server 和官方 SDK 三个组件在 github.com/openai/codex 下以 Apache-2.0 许可发布。Codex CLI 早在 2025 年 4 月就已开源,此次平台介绍进一步明确了开发者可用的组件。OpenAI 此前公布的一组实验,也说明了执行框架的作用:同一个 GPT-5.6 Sol 模型,只改变两项 harness 设置,在 ARC-AGI-3 上的分数就从 13.3% 升到 38.3%,输出 token 降到原来的六分之一。
框架管理任务、工具和审批,模型权重仍未开放
一个能持续自主工作的 agent,需要的不只是一次模型推理。它要理解任务、跨多轮保持上下文、查看信息、调用工具、报告进度、失败后恢复、必要时请求人类批准——负责组织这些步骤的执行框架,就称为 harness。OpenAI 对它的定义很直接:harness 负责管理对话状态、流式执行、工具调用,执行配置好的沙箱与审批策略,并把工作跨轮次延续下去。
这次开源分成三个入口。codex exec 面向脚本、CI 或一次性后台任务,跑一个受约束的 agent 工作流并返回结构化输出;官方 Codex SDK 提供程序化接口,供应用代码启动、恢复或流式接收 Codex 任务;app-server 则通过一套文档化的客户端协议暴露能力,让应用创建线程、启动轮次、接收事件、处理审批请求。Harness 本身用 Rust 写成(仓库里的 codex-rs 目录)。
开源范围需要与模型访问区分开:OpenAI 开放的是 harness 与集成层,不是模型。官方原话是"The open-source layer is the harness and integration surface; model access and managed services remain separate"——GPT-5.6 Sol 的权重没有开源,模型访问与云托管服务仍是闭源、收费的。开发者可以自行使用和集成这些执行组件,模型本身依然只能通过 OpenAI 的 API 或订阅来调用。
保留推理与压缩上下文,如何提高游戏测试成绩
一个具体例子来自 OpenAI 在 7 月 29 日那篇《How enabling two settings tripled our scores》里记录的一次对照实验。ARC-AGI-3 是 ARC Prize 推出的 2D 交互游戏基准,模型进入陌生的游戏环境,没有规则说明,要靠试错推断机制,评分用的是 RHAE(相对人类动作效率),同时衡量通关率与动作效率。
GPT-5.6 Sol 在 ARC 官方提供的通用 harness 下只拿到 13.3%。OpenAI 认为,官方 harness 中的两项处理方式限制了模型表现:一是每次动作后私有推理被丢弃,模型需要反复推断此前已经考虑过的游戏规则;二是用滚动截断处理超长上下文,历史一长,早期的动作连同经验一起被丢掉。这两种处理都会丢失模型此前形成的推理或经验。
OpenAI 只改了两项设置。第一项是保留推理(retained reasoning):模型动作前的私有思考链被保留在对话历史里,于是它不必每步从零解释局面,学得更快、每步想得更少。第二项是上下文压缩(compaction):对话过长时用摘要压缩代替直接截断,把已学到的游戏经验带过更长的时间跨度。两项叠加,同一模型在公开集上拿到 38.3%,输出 token 降到约六分之一。
这里有两层边界不能省。其一,13.3% 是"ARC 官方通用 harness"下的分数,不是 OpenAI 自己优化前后的对比——它显示的是执行框架选择对成绩的影响,不能表述成 OpenAI 将自家框架的成绩提高了三倍。其二,即便升到 38.3%,仍低于 OpenAI 估计的人类测试者平均约 48% 的水平。因此,这组结果更适合解释框架设置的影响,尚不足以说明模型已达到人类水平。
Nvidia 的测试也显示,执行框架会影响模型表现
Nvidia 也公布了智能体架构影响基准成绩的例子。8 月 21 日,Nvidia 研究团队宣布其智能体架构 AVO 在 ARC-AGI-3 公开集拿到 100.00 的 RHAE 分数,清完 25 个环境、183 个关卡——而它底层的模型是 Anthropic 的 Claude Opus 5,这个模型被 ARC Prize 单独评测时只拿到约 30%。
两组实验都提示:评测一个模型,不等于评测一个 agent。OpenAI 从 13.3% 到 38.3%,靠的是改 harness 设置;Nvidia 从约 30% 到 100%,靠的是换掉整套 agent 架构(持久记忆加监督循环)。Nvidia 在博客里写得更直白:"The model matters, but the model is not the entire agent."(模型重要,但模型不是 agent 的全部。)
这些结果说明,比较长期任务能力时,除了模型本身,也要考察执行系统。两家公司发布的材料还给出了可供比较的产品——Nvidia 的博客顺带点明,VISTA 系统分别用 Claude Opus 5 跑在 Claude Code、GPT-5.6 Sol 跑在 Codex 上,Claude Code 与 Codex 都承担了运行智能体的工作。
编码与报税案例,展示框架怎样接入现有工作流
OpenAI 用几个已经上线的案例说明,这套模式不局限于写代码。据官方博客,Cisco 在 Cloud Control 的 App Builder 里用 Codex SDK 构建自定义工具;Thrive Holdings 与 Crete 用 Codex 搭了一个报税工作流,把税务从业者的反馈直接纳入 agent 流程,试点处理了 7000 份报税单,准备时间减少约三分之一;GitHub 与 JetBrains 则把 Codex 作为 agent provider 接进 JetBrains IDE。OpenAI 自己也做了个示例应用 Relay,把 agent 放在一个虚构的物流仪表盘旁,任何有后果的写操作都要经过人工批准。
这些案例都把 agent 嵌入用户已经熟悉的产品和工作流——安全分析师有调查队列,客服有账户历史和内部文档,产品经理有任务看板。harness 负责底层循环,产品继续拥有自己的界面、数据与审批流程。这一部分证据来自 OpenAI 官方博客,属于厂商自述,未经独立审计,可以作为框架如何接入产品的案例,实际收益仍需独立复核。
开发者可以复用框架,仍需考虑模型费用和服务依赖
开源执行框架,为 OpenAI 提供了模型能力之外的竞争方式。开发者可以复用工具调用、状态管理和审批等组件,模型与托管服务则继续收费。能否借此吸引更多开发者,还要看这些组件是否容易集成、能否满足实际产品需求。
开发者和企业需要比较几种方案的成本:自行开发执行框架、采用厂商的闭源平台,或使用 OpenAI 的开源框架。OpenAI 则希望通过开放框架扩大采用范围。它能否成为通用选择,取决于开发者是否愿意把这些组件接入自己的产品。
仍需观察的变量有三:其一,38.3% 仍低于人类基线,这两项框架设置尚不足以让模型在该测试中达到人类水平;其二,开源组件与闭源 Codex 产品之间的确切边界并不完全透明,官方只说"模型访问与托管服务仍独立",内部是否仍有闭源组件未公开;其三,企业案例与关键数字均出自 OpenAI 官方,缺少独立第三方对 7000 份报税单或 Cisco 部署的复核。这些问题将影响开发者能否复用案例中的收益,也会影响执行框架最终能形成多大的竞争优势。