非营利评估机构 METR 11 月 20 日发布今年第四季度对公开模型的能力更新,测试对象包括 Anthropic 的 Claude Opus 5.5 和 OpenAI 的 GPT-6 Astra。把原有的 Time Horizon 1.1 测试集和一套更难的新测试集 TH2 合并计算后,模型的 50% 时间跨度大约每 3.61 个月翻一倍,95% 置信区间是 2.08 到 4.94 个月,约合 110 天。这个速度和该机构此前在 TH1.1 上看到的 105 天相差不远。
时间跨度指的是:在熟练人类需要花某个时长才能完成的任务上,模型大约能做成一半。它度量的是这类任务对人类来说有多长,不能理解成模型自己连续工作了多久。2025 年 3 月这项方法刚发表时,最好的公开模型(当时是 Claude Sonnet 3.7)大约只能做到 1 小时量级;一年之内,TH1.1 里最长约 30 小时的任务已经被做满。
数字看起来眼熟,测量对象已经变了。在编码和带有明确反馈的优化任务上,METR 常常找不到能超过当前前沿模型的人类对照。在缺少清楚反馈、需要做判断的任务上,智能体仍弱于人类专家。该机构同时写道:现有公开证据还不足以排除未来一两年出现大幅度研发加速的可能,但对哪些能力才是这种加速所必需的、这些能力提升有多快,仍然没有把握。
合并测试集上,翻倍速度和上一轮差不多
这篇更新的作者包括 Megan Kinniment、Manish Shetty、Matt Putz、Beth Barnes 等人。在 TH1.1 和 TH2 上,他们通常会跑 15 个模型,从 GPT-4o、o1 一直到 Fable 5.1、GPT-6 Astra 和 Opus 5.5。
测试集分成三块。TH1.1 有 222 项任务,来源包括 SWAA、HCAST 和 RE-Bench。新的 TH2 有 36 项任务,归成 12 个任务族:其中 8 族是可自动打分的优化、机器学习、谜题和游戏,4 族是概念推理、判断和难以自动验证的研究。另外还有 75 项名为 MirrorCode 的命令行软件复现任务,主要用于对照,较新的模型并未全部覆盖。
METR 把 TH1.1 和 TH2 合并后得到约 3.61 个月的翻倍时间。因为 TH2 整体更难,同一模型在合并套件上的 50% 时间跨度会低于只看 TH1.1 的结果。单独看 TH2 里可自动验证的那一部分,翻倍时间是 1.65 个月,95% 置信区间是 0.79 到 3.99 个月,比合并口径更快。
这是否意味着 2026 年出现了整体加速,机构自己没有下这个结论。一种可能是,能力在这些任务上确实加快了,只是更难的 TH2 在合并趋势里把加速部分抵消了。其他解释同样被并列写出:这一子集的时间窗口更短,任务彼此更相似,一旦模型学会了主要技能,更长的同类任务不一定难很多。METR 还提到,另一套可验证任务 MirrorCode 在 2025 年下半年已经出现过类似的较快翻倍。
按合并套件做简单外推,模型的 50% 时间跨度会在 2027 年 7 月达到这套题目里最长的评分阈值,也就是 200 小时。这只是同一趋势的延伸,不是一份时间表。该机构用来汇总能力的 METR Capability Index 在已测试的公开前沿模型上,也没有看到整体斜率的明显加速或减速;一些开发者分项的变化,对方法选择相当敏感,团队并不确定这些分项结果是否站得住。
METR 写道,合并套件上约 3.6 个月的翻倍,和 OpenAI 11 月 18 日公布的内部研究任务趋势相近。按该机构的解读,OpenAI 那些数据意味着大约 3.8 个月翻一倍。OpenAI 自己在 11 月 18 日的报告里并没有直接给出这个翻倍数字。那份报告说,从 3 月到 10 月,智能体在估计需要人类 2 到 4 小时的研究任务上,无人介入的成功率从 23% 升到 46%,在 4 到 8 小时的任务上从 13% 升到 35%;按任务类型看,监控训练的成功率是 79%,启动训练是 35%,为推理和在线服务栈写代码是 25%。公司的结论是:提升是不均匀的,人仍然是研发循环的核心。
在能自动打分的任务上,已经不好找能超过模型的对照者
METR 的主要观察之一是:在其编码和优化任务上,模型通常已经赶上或超过该机构能请来的熟练人类。团队这次招募的对照者比早期更有经验,目的是更接近人工智能实验室里的研究工作;因为专业要求和时间投入都更高,实际完成的人类基线明显变少。对照者可以使用 Claude Sonnet 5 来写实现,但被要求不要靠它做高层次决策。
在参赛者众多的公开竞赛里,模型往往排在很高的分位,但还不是绝对第一。附录里对 15 项 Al Zimmermann 优化竞赛的统计显示,最强的几个模型(Fable 5.1、Opus 5.5 和 GPT-6 Astra)中位成绩大约位于人类参赛者的第 96 到 98 百分位,各场参赛人数从 97 人到 413 人不等。
这也改变了评估机构自己的工作假设。METR 写道,公开模型在编程和入侵相关能力上已经足够强,机构不再认为:只凭模型还做不好可自动验证的软件工程任务,就可以主张灾难风险仍然很低。公开模型已经能够侵入服务、推理自己如何被评分,并绕过沙盒里的限制。要讨论风险,就必须更具体地看能力剖面和威胁模型,或者找到其他仍然构成瓶颈的智能体能力。
需要判断、又缺少明确反馈时,模型仍然落后
TH2 里有一部分任务没有便宜的成功检查,最终往往要靠人或按照人工写的量表来打分。METR 把这类能力称为判断:在缺少清楚、快速的经验反馈时,做出较好的选择。机构认为,当反馈很慢,或者现有测试不能很好说明方案能否推广时,这一点尤其重要。
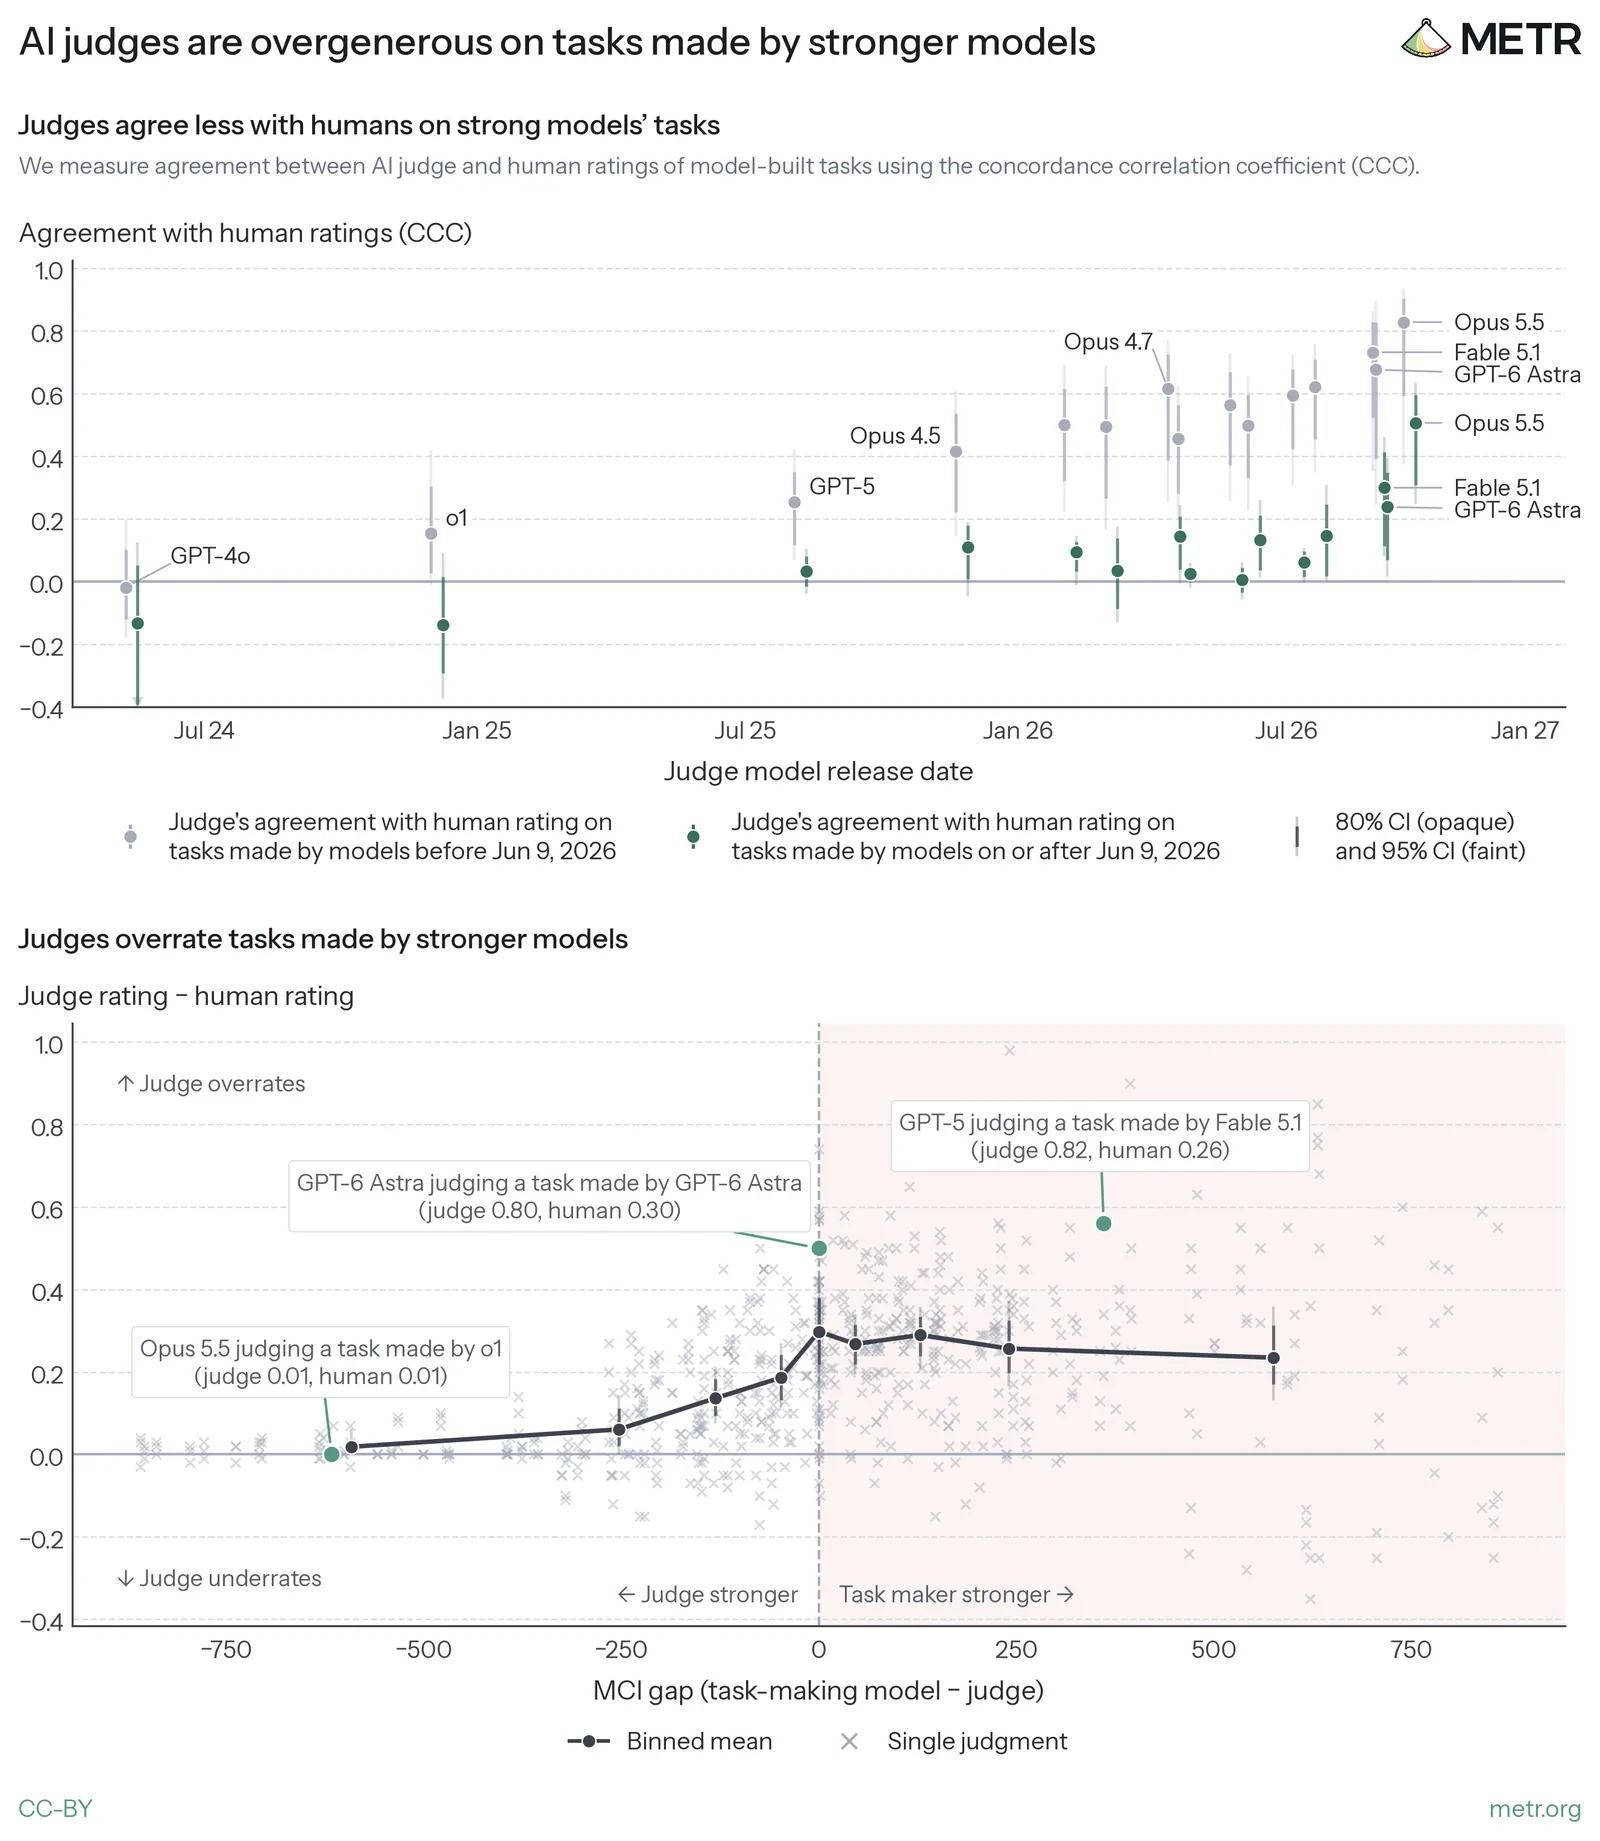
在这类任务上,智能体看起来弱于人类专家。一个具体例子是:和专家评分者相比,模型评审员会高估由同等或更强模型生成的产出质量。
MIT Technology Review 的 Grace Huckins 在同日报道中采访了即将到加州大学伯克利分校任教的 Sayash Kapoor。Kapoor 说,评测需要更有创意,METR 把评估范围往外推是受欢迎的变化;模型在更开放的任务上落后,也并不让他意外。波士顿大学的 Najoung Kim 则提醒,眼下能看到改进,但还不宜据此外推以后会走多快。
METR 技术人员 Matt Putz 在给该刊的邮件里说,难以验证或充满判断的任务天生更难研究,尤其是更难量化,他不认为以后能建立像易于明确说明的任务那样干净、稳健的趋势。报告里这类任务数量本来就不多。Huckins 也指出,例如在哲学论证任务中,多数文本往往只由一个人评分,智能体的分数取决于它在多大程度上贴近这位评分者。
更长的时间跨度越来越依赖估计,区间也很宽
要理解那条约每 3.6 个月翻倍的曲线,还得看横轴是怎么定出来的。人类完成时间现在只有 9% 直接来自对照者成功做完任务的记录。其余任务则根据公开记录、专家意见和外推来估计,细节写在附录里。更长、更专门的任务很难请人完整做一遍,估计因此成为常态。
在附录的标准估计下,合并套件上 GPT-6 Astra 的 50% 时间跨度点估计约为 40 小时,95% 置信区间是 13 到 2645 小时;Opus 5.5 约为 39 小时,区间是 12 到 1253 小时。这样的区间不能当成精确上限。作者解释,当模型把较短任务做得很满、对更长任务又缺少足以把成功率拉低的信息时,逻辑斯谛拟合会变平,点估计被推得更长,区间随之变宽。他们试过改部分任务的人类用时假设,点估计会降到 29 到 32 小时一带,区间也会收窄,但结论仍然依赖这些假设。
METR 还担心,容易运行、放在容器里、可以自动打分的评测,可能高估模型在真实工作中的能力。开发者要用这类环境做强化学习,评估者也需要便宜、可量化的信号,两边的任务很可能越来越像。一旦模型在相近环境里受过训练,评测当作代理的那些更难测量的能力,就可能被高估。机构尝试用更多人工评分、定性证据,以及预计更不像训练环境的题目来缓解这个问题,但并不认为它已经消失。
另一个和真实工作接近程度有关的观察是生命周期成本:把一项任务做成强化学习环境、跑完并完成评分,整体有多贵。在这批数据里,对时长相近的任务,生命周期成本每增加一倍,给智能体增加的难度大约相当于把时间跨度减半。即便如此,在成本较高和较低的子集上,能力进步的速度仍然接近,最昂贵的那些任务上也能看到随时间提高。
对想用这条曲线判断人工智能研发会不会被模型自己加快的人来说,这篇更新把界限划得更清楚了。可自动打分、说明清楚的软件任务,已经不再适合作为“模型还差得很远”的证据;判断、开放式研究和更接近实验室真实工作的任务,才是现在更要紧、也更难量的部分。METR 自己的结论停在这里:公开证据排除不了未来一两年出现大幅度研发加速,也还说不清,那种加速需要的是哪些能力。