如果问题是“2021 年 7 月 12 日,成都平原有多少耕地的温度植被干旱指数高于 0.75”,一张卫星图片并不能直接给出答案。系统要先找到同一天的地表温度和植被指数产品,下载数据,按各自比例系数校准,把两种栅格对齐,再计算指数、划定耕地并统计面积占比。任何一个日期、波段、文件路径或缩放参数出错,最后的百分比都可能看起来合理,却没有科学意义。
9 月 11 日提交的 Earth-Agent-Pro 论文,正是把这条从问题到数值的链路放进评测。团队将前代 Earth-Bench 的 248 个科学任务改造成需要运行时取数、处理中间文件并生成开放答案的 Earth-Bench-Pro,再用专家技能、结构化记忆和局部修复约束 Agent 执行。结果显示,系统已经更擅长选对工具和保持顺序;最好的工具参数准确率仍只有 32.77%。遥感 Agent 的下一道门槛,已经从“会不会调用工具”移到“每一步能否用对数据和参数,并留下可复核的证据”。
同一道题分三档,才能看出 Agent 卡在哪里
前代 Earth-Bench 有 248 道专家编写的问题、13,729 张图像和 104 个工具,已经同时检查最终答案与工具轨迹。但它把本地输入准备好,答案也采用选择题;Agent 不必证明自己能找到正确数据,数值、日期或单位误差还可能被选项掩盖。
Earth-Bench-Pro 没有另找一批完全不同的问题,而是保留这 248 个科学目标,为每个目标生成三种匹配版本。Instruction-Following 提供排好顺序的工具和准备好的输入,主要检查执行;Autonomous-Planning 隐去工具顺序,保留准备好的输入,增加规划要求;Open-World Execution 只给数据需求,要求 Agent 在运行时获取或发现数据,并依据执行结果写出开放答案。三档合计 744 个问题。
这种设计的价值在于控制变量。同一道题从第一档掉到第二档,问题更可能在规划;从第二档掉到第三档,则新增的数据发现、获取和预处理更可疑。它不是把三个不同数据集的总分硬放在一起比较。
团队重新执行了全部 248 条开放工作流。188 个产品与光谱任务被改成在线取数和预处理,并配有 323 份任务级数据规格,写明来源、产品、波段、空间范围、时间、分辨率、采样间隔和缩放信息;60 个 RGB 任务仍保留用户提供的图像,但具体文件需要在运行时发现。最终的开放工作流包含 1,765 次工具调用,平均每题 7.1 次,覆盖 84 种工具。每一步都记录工具、参数、返回结果和上游来源,答案因此可以沿中间产物倒查。
这也界定了论文所谓的“开放世界”:数据在运行时出现、答案没有候选项,不等于 Agent 可以任意上网、处理任意传感器或创造新工具。系统仍在作者提供的地球观测环境和 112 个工具目录内运行。更早的 OpenEarth-Agent 已用 596 个案例评测数据准备、特征提取和地理分析,并让 Agent 动态生成工具;Earth-Bench-Pro 的独特增量,是把相同科学目标做成三档配对问题,并把开放答案、工具参数与中间证据放进同一评测链。
六份专家技能缩小搜索空间,失败后只重做后半程
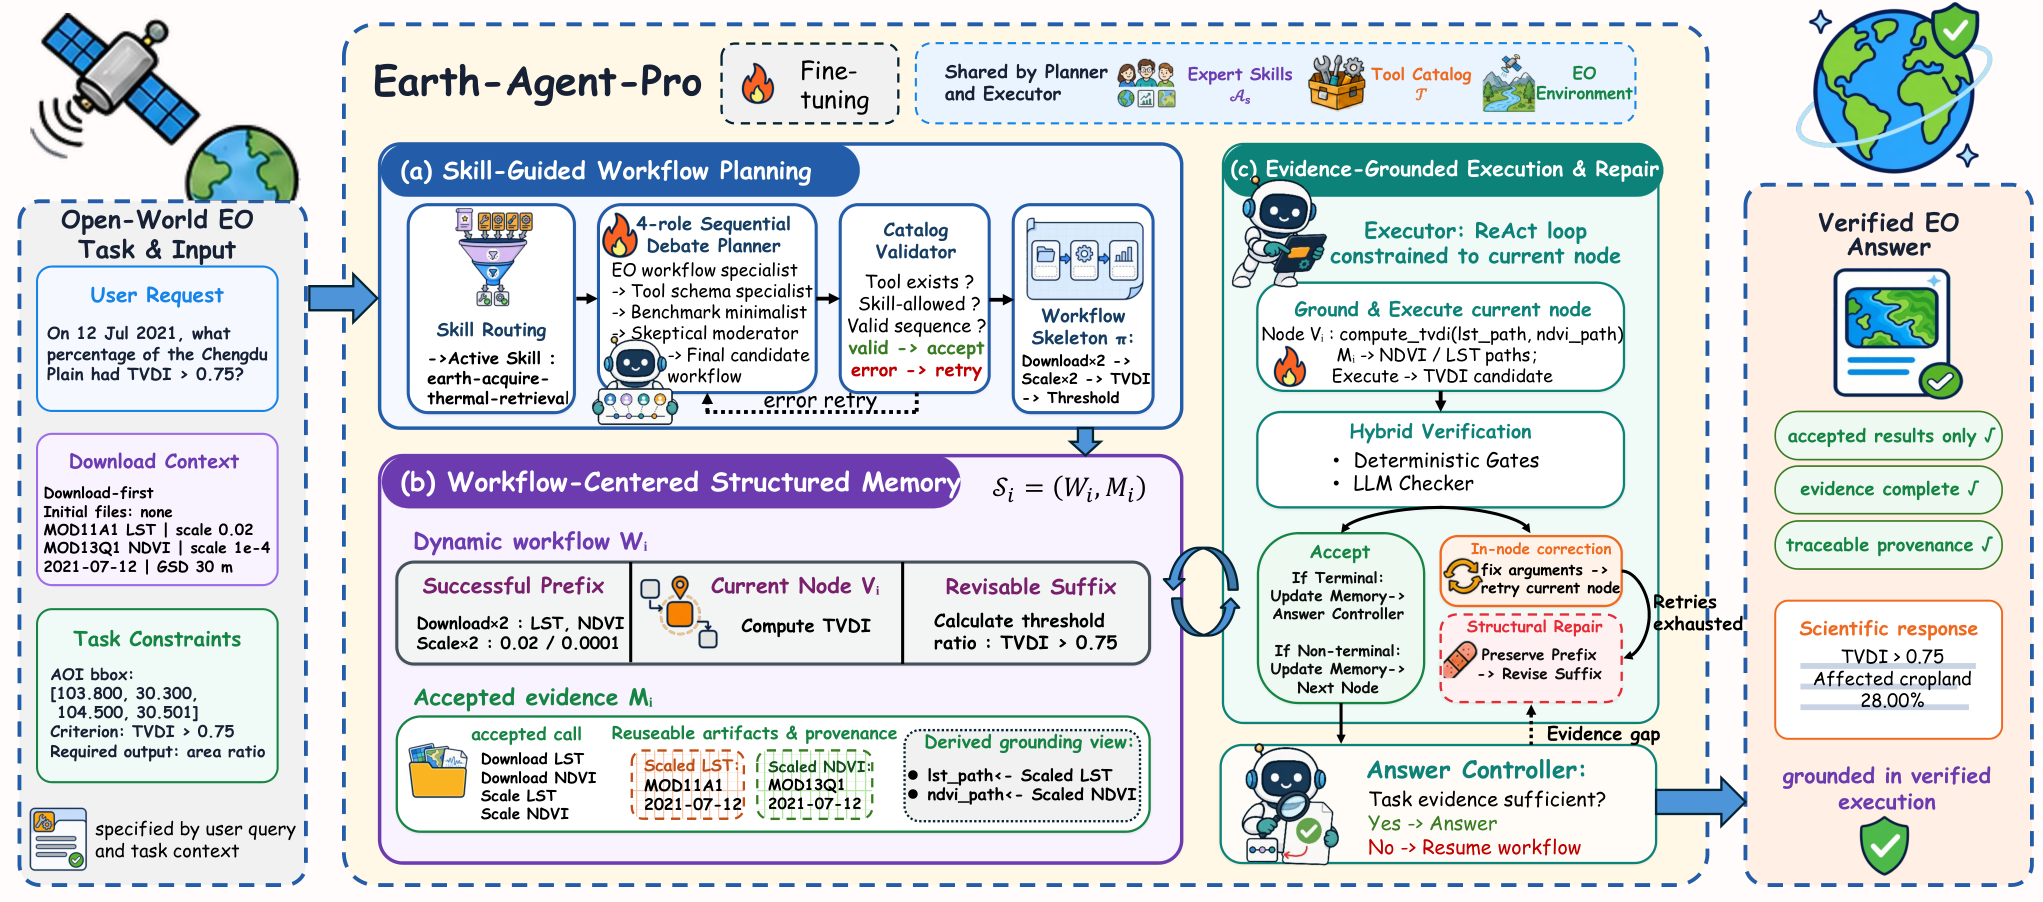
Earth-Agent-Pro 把规划和执行拆开。Planner 先从六份专家技能中选择适用规范,再把 112 个工具缩小为当前任务的候选集合。四个顺序参与的角色分别检查地球观测流程、工具接口、路径是否精简和最终能否执行,随后由目录校验器排除不存在或不被当前技能允许的工具,得到工作流骨架。
Executor 再逐节点补齐真实参数。它看到的不是不断膨胀的聊天记录,而是一份结构化状态:已经成功的前缀、当前节点、可以修改的后缀,以及只包含已接受调用的证据记录。确定性规则先检查结构错误、错误标记和批次覆盖;规则无法判断时,再由模型检查结果是否满足任务与技能约束。
一次调用失败时,系统先在当前节点修正参数或替换工具。多次尝试仍失败,Planner 只重写故障节点之后的工作流,已经验证过的下载文件、校准结果和来源关系继续保留。即使所有工具都成功,Answer Controller 还会检查计算是否完整、时空范围是否覆盖、单位和数值尺度是否合理;证据不够就重新打开相关节点,而不是直接组织一段答案。
这套机制解决的是长链任务里最昂贵的错误传播:前面已经下载并校准好的遥感数据,不必因为后面一个统计操作失败而全部重做。它也让失败位置更容易诊断——究竟是选错工具、参数不合法、漏了中间表示,还是最后把正确结果解释错了。
工具顺序进步很大,参数只小幅改善
在 Earth-Bench-Pro 的开放执行档,作者用同一个 GPT-5 骨干、工具集和技能集比较四种 Agent 框架。ReAct 的 LLM 裁判正确率为 45.18%,Earth-Agent-Pro 为 66.13%,提高 20.95 个百分点;Tools-In-Order 从 47.53% 升到 71.97%,Tool-Exact-Match 从 43.33% 升到 60.14%。这些结果支持一个明确结论:在相同模型下,技能约束、显式工作流和执行修复能让轨迹更接近专家流程。
参数却没有同步变得可靠。Earth-Agent-Pro 的 GPT-5 版本参数准确率仅从 ReAct 的 24.33% 提高到 27.28%。整张主结果表里,最高值来自微调后的 Qwen3.5-9B,也只有 32.77%;它虽然达到 91.28% 的 Tools-Any-Order 和 81.11% 的 Tools-In-Order,严格参数匹配仍不足三分之一。会选工具、会排顺序,与把日期、波段、空间范围、缩放系数和上一步文件路径逐项填对,是两种不同能力。
论文的案例把这种断点表现得很具体。在巴黎城市热岛任务中,流程需要下载 ASTER 产品,提取第 10 至 12 波段,用热红外方法反演地表温度,再分别汇总城市与乡村区域。直接使用 GPT-5 的轨迹跳过波段提取,得到 24.25 K;Qwen3.5-9B 虽然有提取步骤,却把热处理和聚合参数填错,结果为 0 K。Earth-Agent-Pro 保留了完整依赖链,得到与参考答案一致的 43.3131 K。
另一个网球场面积任务说明,中间产物也不能省。GPT-5 和 Qwen3.5-9B 都检测到了球场,却直接用粗糙检测框计算面积,得到 1,584.74 平方米;Earth-Agent-Pro 在检测与测量之间加入像素级分割,按 0.13 米的地面分辨率算出 879.3746 平方米,接近约 880 平方米的参考值。
系统并不总能修好后半程。在东北平原植被覆盖变化任务中,三种方法都完成了 MODIS 产品下载、辐射校准和区域均值计算。GPT-5 继续使用参考流程中的变化分析与最大值操作,得到 72.17%,接近 72.1% 的答案;作者系统选错后续运算,只得到 5.49%。上游数据正确,并不能防止 Agent 在最后一步误解科学运算的含义。
“66.13% 正确”不能替代可机械核验的轨迹
66.13% 衡量的是模型裁判对开放答案的判断,不是参数逐项正确率。论文还报告词面重合、语义匹配、工具覆盖、工具顺序、严格轨迹匹配和参数准确率;这些指标回答不同问题,不能合并成一个“完成率”。主结果里,GPT-5 的裁判分最高,而微调 9B 模型的工具与参数指标最高,说明更像专家轨迹的执行并不自动产生更好的最终表述,反过来也一样。
跨基准结果进一步限制了“全面领先”的说法。在 OpenEarthAgent 的 Spectrum、Products 和 RGB 子任务上,Earth-Agent-Pro 的 GPT-5 版本平均准确率为 75%,高于 Codex 的 46.67%;但 Products 一项由 Codex 以 75% 对 55% 领先。微调 9B 版本的平均准确率从 50% 升到 58.33%,平均延迟也从 67.83 秒增加到 111.79 秒。作者加入的技能会让轨迹略长,换来更好的答案和顺序指标,质量收益存在可见的执行成本。
微调结果还需要更严格的泛化检验。论文称,训练数据由 248 个种子工作流扩增成 2,480 条轨迹;扩增会替换地点、边界框、时间和文件等实例状态,同时固定传感器、波段、工具顺序、参数模式和依赖结构。论文没有说明这些工作流骨架与 248 个评测任务之间采用了怎样的 held-out 划分。相比之下,OpenEarthAgent 明确报告 14,538 条训练样本和 1,169 条留出测试样本。因此,当前结果可以证明角色化微调提升了这套任务分布内的执行指标,还不足以证明模型学会了此前未见的科学工作流。
下一步不是再加一个总分,而是公开可重放证据
截至论文 v1,作者写明代码和数据将于之后发布。外部研究者尚不能重放 323 份数据规格、核对在线数据服务变化,也不能检查模型裁判、参数匹配和错误统计的实现。对于依赖实时数据获取的基准,公开的不应只有问题和答案,还应包括数据快照或版本标识、工具与环境版本、完整调用日志、中间文件校验值,以及训练与测试工作流骨架的去重规则。
Earth-Bench-Pro 真正推动行业向前的地方,不是又给遥感 Agent 增加一个总分,而是把“答案从哪里来”变成了评测对象。现在最值得看的也不是 66.13% 还能涨多少,而是参数准确率、未见工作流上的表现和跨环境重放率能否一起提高。只有这三项成立,Agent 输出的百分比才会从一段看似专业的文字,变成科学家可以接手复核的结果。