9 月 6 日,OpenAI 公开了编程 Agent 进入内部研究流程后的变化:研究人员运行更多实验,也开始把需要更长时间的任务交给模型。公司称,自己已实现此前设定的“自动研究实习生”能力目标,可以在人类指导下完成原本需要熟练研究员数天的明确任务。对于正在搭建自动研究系统的团队,这份披露把一个问题推到了眼前:当 AI 已经参与研发下一代 AI,它会让此后的每一轮研发都加速多少?OpenAI 内部研究披露
递归自我改进(RSI)讨论的就是这种回流:现有系统促成改进,改进后的系统又参与下一轮改进。但“参与了”还不足以推算“会越来越快”。一次节省时间、某个阶段的研发提效,以及能力增长率持续上升,需要分别验证。
7 月 13 日,Tom Cunningham 等研究者发表的《递归自我改进的经济学》尝试把这个问题拆成可测量的关系;METR 的两位共同作者随后在 7 月 22 日解释,关键在于反馈有多强,特别是更强模型究竟能增加多少算法进展。到了 9 月,实验室提供了更多观测材料,但还不能把一张使用量曲线直接接到下一代模型的能力曲线上。经济学论文、METR 作者说明
一项改进怎样提高下一代模型的研究能力
先考虑一个示意性的训练项目。Agent 提出一种改法,小规模实验显示它能用更少计算达到相同质量。研究团队复跑后,把它放进正式训练;新模型因而在同样预算下获得更好的研究能力,随后被用来寻找下一种改法。到最后一步,这项收益才重新进入产生改进的流程。
沿着这条链,需要看清三次转换:模型带来多少有效研究,研究产出多少可用改进,改进又怎样增强后继系统。
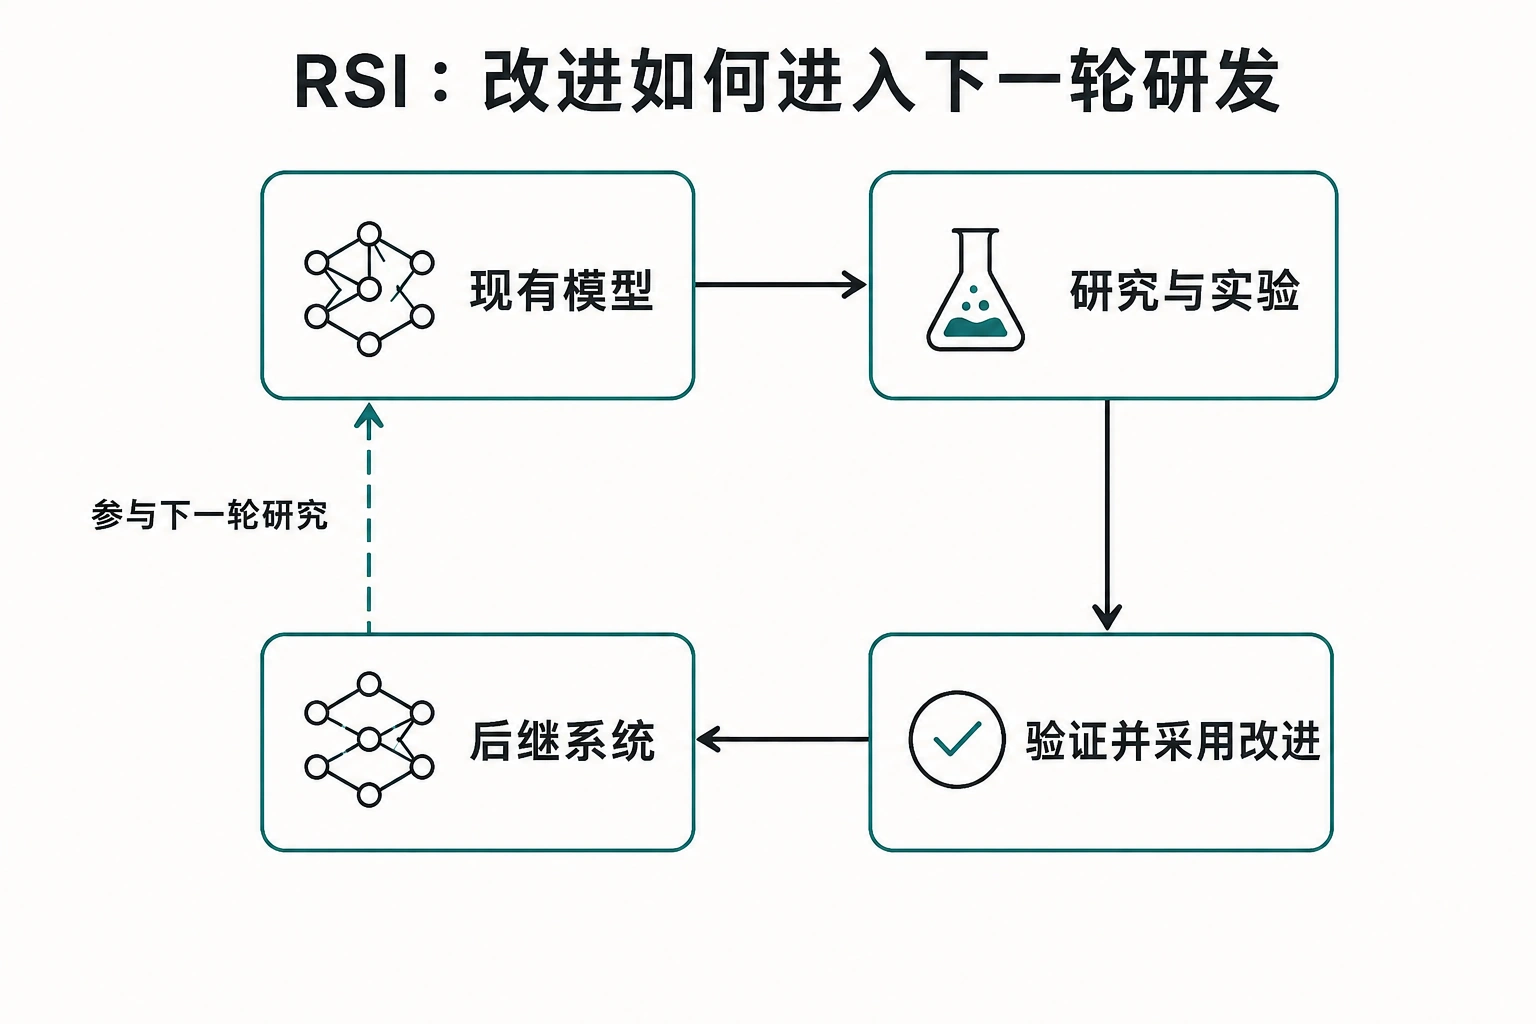
制图:AGI Daily(AI 生成),依据《递归自我改进的经济学》。
三段中的“好”并不总是一回事。第一段可以表现为少花人工时间;第二段需要一个经过验证的研究产出;第三段则要证明这个产出增强了后继系统的研究能力。例如,省下训练计算是一项收益,但团队也可以选择把它用于降低成本,或者改善与研究无关的产品体验。只有知道收益实际去了哪里,才能估计它对下一轮的贡献。
这也解释了为什么不宜把“模型权重有没有更新”当作唯一分界。改进可以保存在工具、程序或工作流里;需要检查的是,新系统是否继承这些变化,并凭借它们更有效地产生后续改进。
继续改进模型,可能需要越来越多次尝试
在 Cunningham 等人的模型中,反馈链每一段都有一个“敏感度”:其他条件不变时,输入增加一定比例,输出会增加多少。沿一条回路,这些敏感度相乘;再把已有进展对继续发现改进的难度影响计入,才能判断增长率是上升、持平还是下降。单独把其中某一段做得很快,无法确定整条回路的结果。论文的反馈条件
可以用一个明确标为示意的例子理解收益递减:团队原本每周能验证一项改进;工具升级后,每周能验证更多候选方法。但如果容易奏效的方法已被试尽,得到下一项同样有价值的结果,可能需要更多次尝试。新增研究能力要先补上这一部分,剩余收益才可能提高后续进展速度。候选数量增长,与有效进展的增长率上升,是两个观测对象。
因此,研究团队既要问“新模型让我多做了多少工作”,也要问“做到当前水平后,继续前进需要多做多少工作”。后一个量会随研究方向、技术阶段和任务难度变化,不能永远沿用首次实验的收益。
该论文用“外部投入不再增长,能力进展仍能加速”定义一种较强的情形,称为自我维持的加速。固定人力和算力,是用来隔离反馈贡献的分析条件,并非所有 RSI 用法都必须满足的定义。现实中的人员扩张、算力投入、数据积累可以与算法反馈同时发生;它们也可能缓解原有约束。METR 的作者明确表示,现有证据不足以排除一段持续而快速的能力加速,论文的参数校准仍然很粗略。METR 对定义与不确定性的说明
对建设自动研究平台的团队,这个区分会改变采购和研发判断。一次工具升级即使不能启动持续加速,也可能值得采用;反过来,一项改进看起来便宜,若后续收益依赖不断增加的搜索与验证成本,就不能据此推算未来每一代都会更划算。
METR 在 7 月 21 日提出的“支出视界”提供了一种测量办法:画出人类与 Agent 在不同预算下能取得多少优化收益,比较两条曲线在哪个预算水平相交。配图来自其 NanoGPT 实验,同时展示累计支出与继续增加支出时的收益。人类成本估计、Agent 的运行框架都会影响结果,纯 Agent 优化也不能代表人机合作;它的价值是把一个最终成绩展开成投入与产出的关系。METR 的成本与收益测量
AI 已能改进自身代码、缩短模型训练时间
Darwin Gödel Machine(DGM)提供了一个具体的系统级闭环。它保持底层预训练模型冻结,让编程 Agent 修改自己的代码;修改后的版本经过任务评估,进入候选库,再参与后续自改。改善的对象包括工具使用和工作流,而非重新训练一个基础模型。
论文第三版还报告了跨基准迁移:在 SWE-bench 上演化出的最佳 Agent,放到该轮优化未接触的 Polyglot 后,解题率为 28.9%,初始 Agent 为 14.2%。这说明其收益不只出现在原先用来筛选后代的题目上。与此同时,作者估算 SWE-bench 主运行约花费 2.2 万美元,两个消融基线各约 1 万美元;这组实验没有给出等成本条件下的完整比较,也没有直接测量多轮研发的增长率。DGM 方法、持出测试与成本
另一类证据来自成果进入实际训练流程。Google DeepMind 在 2025 年 5 月介绍 AlphaEvolve 时称,它通过生成程序、执行评估和筛选结果来寻找改进。其找到的一项矩阵运算优化,使 Gemini 的一个关键计算内核提速 23%,对应总训练时间减少 1%。AlphaEvolve 官方披露
这两项结果分别推进了取证链的不同位置:DGM 展示后代系统保留了可迁移的能力收益;AlphaEvolve 展示自动发现的程序改进进入了训练生产过程。对于后者,下一步还要跟踪:节约的资源是否投入了后续研究,采用改进训练出的模型又贡献了多少新收益。官方披露没有给出这套逐代归因结果。
把这些实验统称为“尚未证明智能爆炸”会漏掉已有进展;把局部收益直接外推为持续自我加速,则会跳过后续几段关系。技术评估需要保留它们各自已经完成的部分。
研发提速有多少来自 AI,目前还难单独算清
实验室内部可以观测更完整的研发活动,却同样面临归因问题。OpenAI 报告实验量增加时,也说明可用算力自 2025 年以来显著增长。模型使用、算力供给与实验产出一起上升,仍不足以算出模型升级单独带来了多少进展。OpenAI 对测量条件的说明
Anthropic 的八月风险报告更接近整体进展口径,但其覆盖日期是 2026 年 7 月 15 日。公司判断,2025 年前中期以来出现了有意义、但不足两倍的加速;它把 2025 年的加速主要归于 AI 使用以外的因素,同时认为 AI 帮助较快趋势延续到了报告覆盖日期。公司也承认,整体判断存在不确定性和测量滞后。不能据此读出 Anthropic 在 9 月的即时状态,更不能将该倍数全部归于模型递归贡献。Anthropic 风险报告,§1.3.3、§3.5.2
外部结果记录也还没有给出一致的加速图景。METR 在 8 月 14 日检查包括 nanoGPT、CIFAR-10 在内的七项算法优化历史记录,认为未观察到清晰、显著的整体提速,其中已有记录包含 LLM 贡献。但这项分析只覆盖公开成果,作者提醒数据质量和披露差异会影响判断,实验室也可能保留了更有价值的内部发现。它约束的是“公开算法记录已普遍显示加速”这一说法,无法排除未公开的反馈。METR 对公开发现的分析
还有一个容易被单次成绩遮住的变量:回流需要时间。Mikhail Burtsev 在 8 月 31 日提交的《AI 自我改进的递归临界性》把研发周期明确放入模型。一个方法从提出,到验证、整合、训练后继系统,再回到研究工作,中间存在延迟。在其理论设定中,即使反馈已经能放大改进,表现为明显加速也可能需要时间;吞吐量足够高以后,只增加研究工作量,仍会受到这一回流周期的限制。论文的数值情景用于比较机制,关键参数尚缺直接实证约束,不能当作 AGI 时间预测。Burtsev 预印本,§2.2、§3
由此看,公开曲线没有突然变陡,并不能立即说明反馈很弱;突然变陡也可能来自其他投入。要区分这些解释,需要知道改进发生、被采用、进入后继系统和再次产生收益的各个日期。
验证持续加速,需要逐代比较模型的研究成果
对希望评估 RSI 的实验室,最有辨别力的数据可以从一个具体研究目标开始:在质量要求一致的条件下,分别让人类团队、使用旧模型的团队和使用新模型的团队完成工作。记录全部尝试、人工指导与审查时间、模型推理消耗以及实验计算,并把验证成功、最终采用与未能采用的结果分开。
有了这一步,才能继续问:模型升级带来的收益,在增加验证成本后还剩多少;在同一任务组持续研究时,单位资源带来的改进是否衰减;已采用的方法到了更大训练规模和新任务上,是否仍然有效。这些是可以逐项报告的比较,无需先把它们压成一个“RSI 分数”。
更强的证据应继续追到后继系统:有、无这项改进的系统,在下一轮研究里分别完成了什么?后代继承的收益,又花了多久转化为下一项可用成果?这样的连续记录才能检验递归的因果关系,而不只是为一串成功案例排列代号。
目前公开材料支持 AI 已经参与研发、某些自改结果能够迁移、部分优化能够进入训练流程。要把判断推进到“反馈正持续加速研发”,下一项关键观测应是:在说明资源变化和研发周期之后,前一代带来的能力增量,是否在后几代继续产生更大的有效研究增量。

