独立评估机构 METR 11 月 5 日公布了对 Anthropic 的高权限评估。从 8 月 12 日到 10 月 29 日,评估人员查看了预训练、强化学习、各环节训练算力、内部模型基准、AI 提速分析和员工访谈等内部材料。评估结束后,多数参与者认为:到 2026 年 10 月,Anthropic 在目标明确的任务上改进模型能力的速度,大约是 2024 年 3 月至 2025 年 10 月的两倍。他们也写明不确定性很高,真实加速更接近 1.3 倍或 3 倍,都不会让他们意外。
支撑这些判断的许多证据没有出现在公开文本里。METR 写道,Anthropic 有权涂掉任何非公开信息,并涂掉了多数对结论最有信息量的证据。公开版因此「没有做到对证据的透明」,公众只能比理想情况更依赖评估者自己的综合判断。
内部基准约 1.9 倍加速,原因不是训练算力涨得更快
METR 能公开给出的最硬数字,来自 AECI。这是 Anthropic 版的 Epoch Capabilities Index,用来把多项基准合成一条能力曲线。按评估团队的主估计,2025 年 10 月以来,Anthropic 内部模型的 AECI 增速约为此前的 1.9 倍,95% 置信区间是 1.5 倍到 2.8 倍。换一种说法:过去一年里,公司在基准上走过的路程,大约相当于 2023 年 10 月到 2025 年 10 月、从 Claude 2.1 到 Sonnet 4.5 这两年。
趋势转折点被估计在 2025 年 10 月 7 日。时间轴用的不是公开发布日,而是「大多数 Anthropic 员工已经能用上该快照」的日期,以便和从未对外发布的模型对齐。评估纳入了几个内部代号:2022 年训完、从未发布的 Unreleased 2022;2026 年 7 月训完的 Model 2;8 月至 9 月训完的 Model 3;9 月至 10 月训完的 Model 4。METR 说明,这些是分享给评估团队的代号,公司内部另有名称。
这也能解释,为什么这个 1.9 倍高于 Anthropic 在 Haiku 5.5 系统卡里写过的 1.7 倍:主要差别是纳入了更新的未发布模型。如果把其他公司的前沿模型一并画进同一条 AECI 趋势,估计出的加速会降到约 1.4 倍。METR 给出两种读法。一种是 Anthropic 在 2025 年还落后于行业前沿,历史斜率被低估,因而 1.9 倍偏高;另一种是其他模型更贴基准,历史斜率被高估,因而 1.4 倍偏低。
替换链接函数、快照、基准子集或正则化之后,加速估计大致落在 1.1 倍到 2.9 倍。默认使用的 logistic 函数给出 1.9 倍。评估团队说,他们会对「完全没有加速」或「超过 3 倍」感到意外。他们也有把握排除一种常见解释:加速不是因为训练算力规模涨得更快。关于这一点的细节被涂黑了。
测量本身也开始吃紧。Model 4 在它参加的全部 15 项 AECI 基准上都超过了 50%。九个月前,Opus 4.6 还有不少基准低于这条线。评估团队担心,以后会越来越难找到足够难的题目来跟上能力变化。
METR 猜测眼下约八成加速来自 AI 辅助
能力曲线变陡之后,下一个问题是原因。评估团队查看了算力扩张、招聘、数据改进、算法发现和其他瓶颈。他们确信训练算力的增速解释不了这次加速;除此之外,Anthropic 自己的员工也没有形成共识,评估团队也没找到决定性证据。
他们的主观估计分两段。2025 年底那一轮加速,很可能受到非 AI 因素影响,其中许多细节被涂黑。到 2026 年 10 月,他们猜测当前加速的一多半、大约八成来自 Anthropic 大量用 AI 做研发。这个判断带着明显不确定性,依据是多条关于 AI 贡献和其他因素的线索。他们还认为,AI 的贡献随时间变得更重要,所调查的其他因素解释不了加速为何持续。
访谈和调查与「大约翻倍」大体相容。METR 和 Anthropic 都访谈了不少研究者,印象是估计值分布很宽,中心大致在 2 倍附近。评估团队用 Claude 给访谈摘录分类:明确支持本领域因 AI 加速超过 2 倍的有 2 人,偏向支持 3 人,边界或说不清 4 人,偏向否定 0 人,明确不支持 2 人。一名研究者说,自己现在只卡在想法和算力上,不再卡在写代码。另有研究者把最大原因归给招聘,也有人表示不相信自评的生产率增长。
员工在 Slack 投票里自报的提效更高,也更不宜直接外推。METR 把这类数据称作非常松散的证据:样本未必有代表性,回答也谈不上深思熟虑。即便如此,自报数字一直在长。对 2026 年 10 月最强的内部模型,平均值大约是 12 倍。
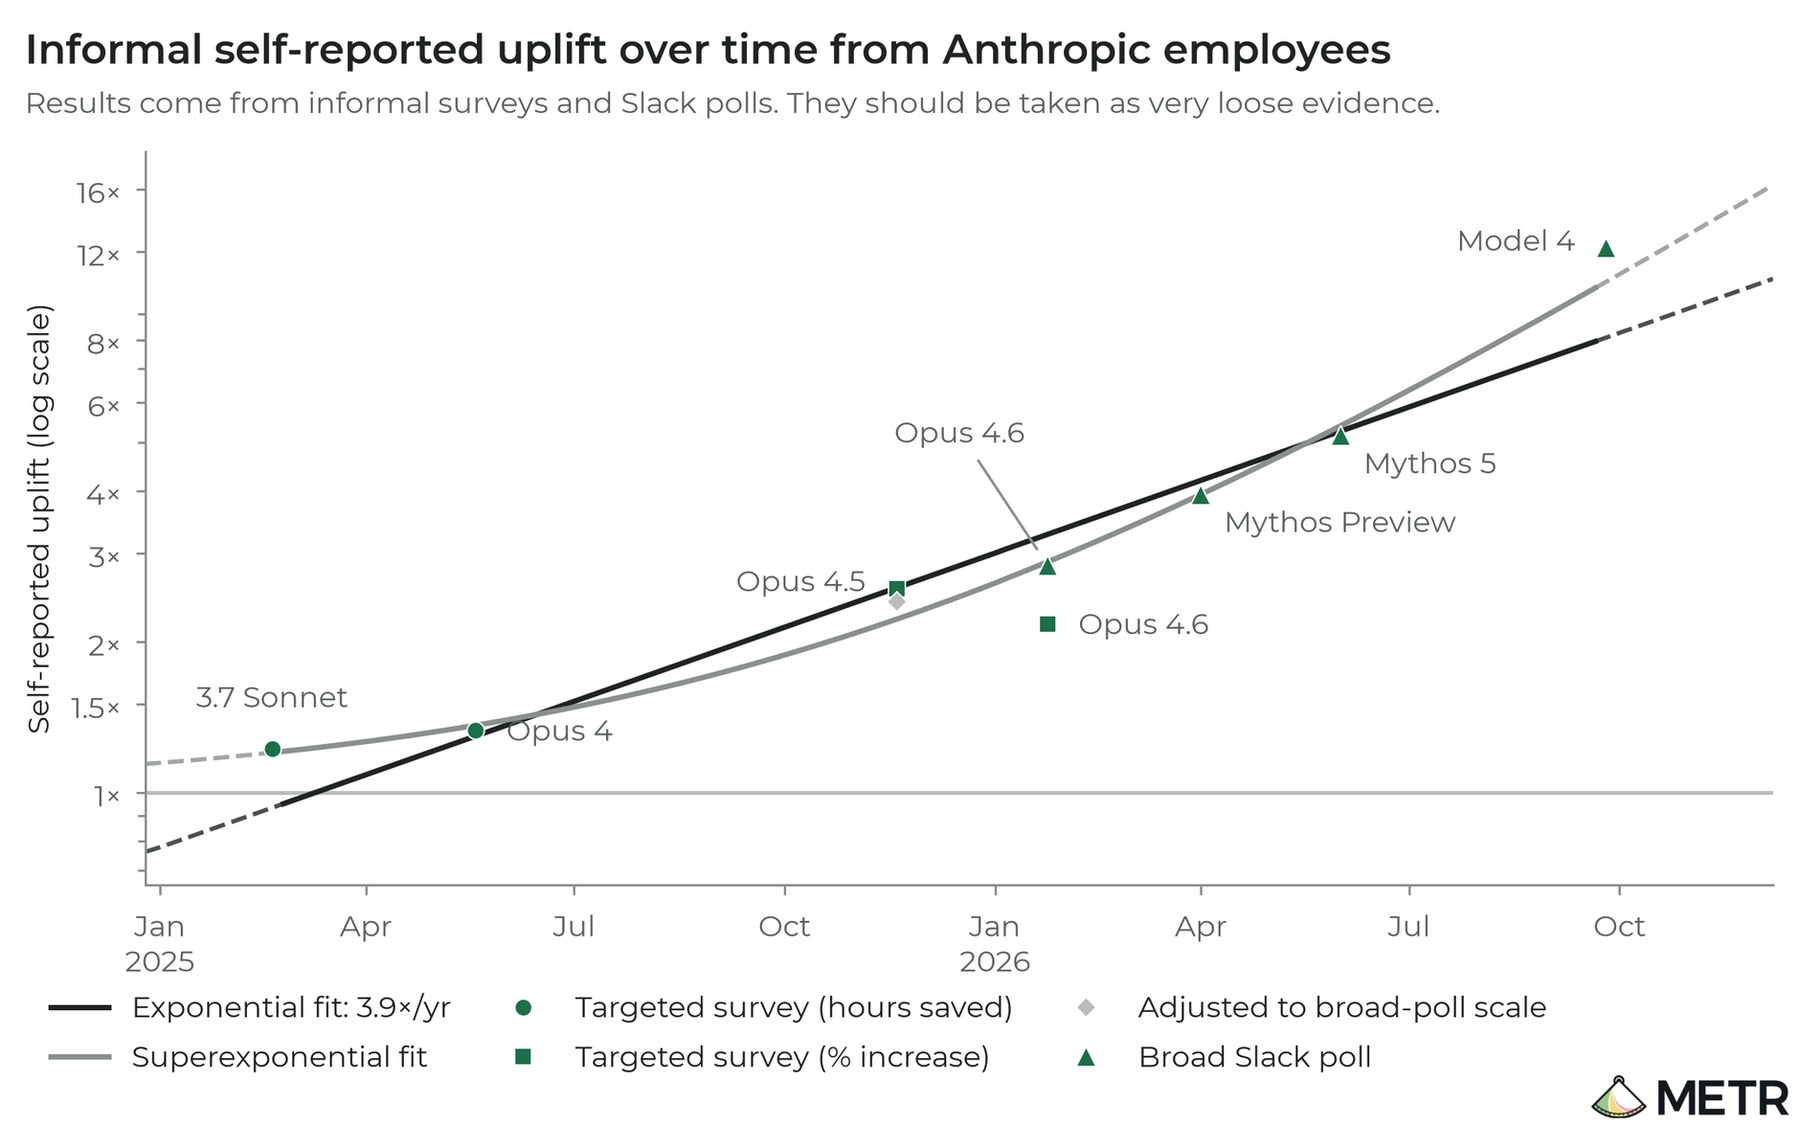
个人觉得自己快了多少,并不等于组织级能力增速翻了多少。要让模型能力这类产出维持同样的增长速度,通常需要劳动力或劳动生产率也以相近速度增长,才能抵消收益递减。评估团队因此更关心自报提效的增速有没有明显变化,而不是 12 倍这个绝对值。他们就「需要多快的个人提效才能解释各环节加速」做了更细的分析,这部分被涂黑了。
完全自主的研发贡献目前还不是主因。METR 了解到,AI 尚不能在模型训练最重要的环节里做出高度显著、完全自主的贡献。研究者也描述了不少初步迹象,暗示这类贡献可能很快出现,但不同环节的成熟度差得很远。细节同样被涂黑。
约百页完整报告里,多数最有信息量的证据被涂黑
METR 在 10 月 22 日把约 100 页的完整报告交给 Anthropic。10 月 25 日公司给出涂黑指引,10 月 27 日至 29 日又收紧了一次。公开报告的最终稿在 11 月 3 日提交。
Anthropic 对所有非公开信息拥有单方面涂黑权。METR 可以单方面说明:审查和涂黑程序是否存在、公司有没有行使这项权利、结论是否显著依赖被涂黑的信息,以及评估获得了什么程度的权限。公开版能自由写出最高层的风险结论;多数最有信息量的证据出不了公司门。
一张对照表把缺口写得很清楚。内部模型的基准能力可以公开讨论;关键中间指标、算法进步估计、研发投入度量、瓶颈与预测细节则基本不能写。AI 贡献的证据和员工访谈只公开了一部分。评估团队因此无法说明:训练管线各环节更细的加速与归因估计;除「不是训练算力加速」之外,算力、数据和算法各自贡献了多少;对未来模型指标的预测。
公司把这些涂黑描述为「旨在去掉可能加速其他 AI 开发者的机密信息」。METR 同意被涂掉的确实属于这类机密,同时指出其中多数信息其实非常高层。评估团队认为自己不适合替公司保守机密的商业利益和公众知情权做权衡,所以只描述涂黑的性质及其对结论的影响。
这次评估最初签了四周,后来延长到十一周,约 2.5 个全职当量。主要作者是 Tom Cunningham、Nate Rush、Parker Whitfill 和 Hjalmar Wijk,另有两名 METR 员工协助和监督。评估人员可以申请任何他们认为有助于理解研发加速的信息,Anthropic 可以批准或拒绝。实践中双方常协商到「有信息量、不过分敏感、也容易分享」的数据。权限超过了评估团队的预期,但不是员工级的自由查阅,也不同于 Anthropic 10 月 15 日宣布的独立评估安排。评估人员没有申请、也没有获得对未公开模型的查询权限,工作在公司设备上进行。METR 没有向 Anthropic 收费,公司提供了免费 token,主要用于辅助分析和绘图。
合同里原先还包括核对算力有多少分给能力研发、有多少分给安全。评估进行到一半,Anthropic 取消了这一部分,改成只评估 AI 对研发的加速。METR 写明,取消发生在他们就算力分配形成实质结论之前。公司的理由是希望眼下把合作集中在风险评估,并表示以后会再谈算力核对。
McCandlish:公开加速路径会让风险更糟
报告公布当天,Anthropic 联合创始人 Sam McCandlish 在 X 上发了一篇长文。他写道,自己负责公司相当一部分安全工作,METR 的许多结论与他本人相符:AI 正在加快研究,但很难精确说出快了多少。评估认为 AI 还不能独自完成模型训练中最重要的贡献,同时也认为,按默认路径,开发速度还可能进一步加快。
对被涂黑的部分,他写得更直接:「我们涂掉了很多内容,我接受这会让其他人更难核查 METR 的工作。但我们认定,把究竟是什么在驱动加速原样公开并不合适,一是因为商业敏感,二是因为它可能给别人一张加快速度的路线图。那会让 METR 担心的风险变得更糟。这是一种权衡。我认为我们做了正确的决定,尽管我们仍在评估其中的利弊。」
他同时说,未来几周公司计划公布自己对 Anthropic 内部 AI 进步速度的分析,包括对照《负责任扩展政策》的位置,以及随着能力快速提高而加强安全与防护措施的新步骤。The Verge 11 月 7 日就这份报告向公司追问,Anthropic 没有额外作答,只让记者去看这篇帖子。
有人追问,为什么要涂掉评估者认为对公众重要的证据。McCandlish 的短答案是:未涂黑的信息会让其他人加快研究,「我们认为安全后果比透明带来的好处更糟」。
这些数字还可能偏高,也可能偏低
即便只看已经公开的部分,评估团队也列出了自己可能看错的方向。
加速可能被低估。增长或许仍在继续加快,甚至接近双曲线;AECI 看到的是模型训完之后的结果,对研发端的加速存在大约一轮训练时长的滞后。完全自动化如果比判断的更近,一旦去掉人力瓶颈,速度还可能再跳一截。基准分数和现实影响之间的关系也不平滑。评估团队举数学为例:相关基准未必明显加速,现实中却出现了困扰人类数十年的千年大奖难题被解决的情形。
加速也可能被高估。非 AI 因素也许解释了大部分近期变化。许多证据测量的是容易自动打分、目标清楚的任务;如果模型在好打分的「干净」任务上,比在头绪杂、不好自动评分的任务上进步更快,现实影响的加速就会低于 AECI。Anthropic 在 2025 年底之前的 AECI 历史增速低于行业前沿,如果那段历史斜率本身偏低,后来的「加速」也会显得更大。
对未来 12 个月,评估团队没有看到算法进步、训练算力、实验算力或数据方面足以挡住继续快速进展的明显瓶颈。他们对这一点并不自信:随着拿到更细的信息,对各类瓶颈的理解反复变过多次。正因为没看到足够强的收益递减,他们才认为存在一种显著风险:能力继续进步,可能在未来一年带来更快的加速。这是风险判断,不是已经证实的递归自我改进。
评估透明度清单也留下了痕迹。由于涂黑,METR 无法提供足以让外界独立复核方法的细节;公司拥有涂黑权,不符合「提供方不得为了隐瞒令人担忧的发现而删改结果」这一项。评估人员没有未发布模型的查询权限,他们自己也认为这对这次评估并不关键。利益冲突方面,一名参与者在项目开始时正与 Anthropic 讨论可能的职位,后来收到工作邀约并拒绝;此人还持有一家竞争对手的股权。按当时有效的政策,其纳入评估的工作须由无利益冲突的同事彻底核对。METR 写明,2026 年 10 月 9 日之后的新评估,遇到这种情况会直接要求回避。
公众现在有了一个独立的高层判断:在目标明确的任务上,Anthropic 的能力增速大约翻了一倍,而 AI 辅助很可能是眼下的主要推力。他们没有的,是自己核验这个判断所需的证据。McCandlish 说公司将在未来几周公布自己的分析。在那之前,评估者看到了什么、公众被允许看到什么,中间这条缝仍然在。
