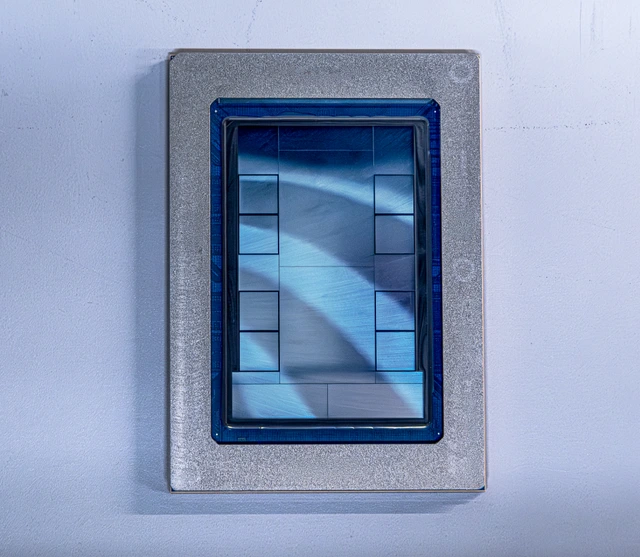
6 月 30 日,AI 推理芯片公司 Etched 公布了此前保密的研发和融资进展:首款芯片已由 TSMC 制造成功,累计融资 8 亿美元,已签署超过 10 亿美元的客户合同。最近一轮融资于 2025 年 12 月完成,金额为 5 亿美元,投后估值为 50 亿美元。
据 TechCrunch 报道,2023 年,创始人 Gavin Uberti 和 Robert Wachen 曾拿着一份 30 页的备忘录,向多家主流风投推销专门为 Transformer 推理设计芯片的想法,却接连遭拒。公司当时现金紧张,一度离关门只差几周。
三年后,这家公司有了在 TSMC N4P 工艺上一次流片成功的 ASIC,一支 400 多人的团队(大部分来自 NVIDIA、Broadcom、Google TPU 和 SK 海力士),以及一份天使投资人名单:Geoffrey Hinton、Andrej Karpathy、李飞飞、Stanley Druckenmiller、Mistral CEO Arthur Mensch 和 Cognition AI 创始人 Scott Wu。
从 Transformer 专用芯片做到整套推理机架
Etched 早期公布的 Sohu 是一种专用集成电路(ASIC),设计思路是把 Transformer 的计算流程固化到芯片中,以减少通用硬件的开销。相比通用 GPU,以及面向更广泛 AI 负载的 Groq LPU 和 Cerebras WSE-3,它更依赖特定模型架构。此次公布的产品则强调芯片、机架、软件与制造的整体设计,公司也把 Mamba 列入已运行的模型名单;早期‘只运行 Transformer’的描述不能直接涵盖最新系统。
公司早期曾宣称,一台搭载 8 颗 Sohu 的服务器在 Llama-70B 推理上可替代 160 颗 H100 GPU。这个比较针对当时的方案,尚不能当作此次机架产品的客户实测结果。新系统公布的技术包括「低电压推理」(LVI)架构——公司称其计算单元电压低于大多数 AI 芯片的一半,运行万亿参数稀疏 MoE 模型时可达到 80% 以上的峰值算力,且不会因过热而降频;以及「集群级内存」(CSM)——结合 HBM 和 SRAM 的混合架构,通过专有低延迟互联实现跨芯片快速内存访问。
公司表示其「前沿推理集群」已在运行 DeepSeek、Qwen、Mamba 和 Llama 等模型,计划于 2026 年夏季交付第一批机架。公司已在圣何塞建设数据中心、测试工厂和 NPI 原型实验室,在台湾设立工厂,目标是 2027 年达到千兆瓦级部署。
累计融资 8 亿美元,投资人包括 Hinton 和李飞飞
Etched 于 2022 年成立,创始人为 Uberti、Wachen 和 Chris Zhu,三人共同获得了 Thiel Fellowship。Primary VC 和 Positive Sum 是公司的早期支持者,两家机构共同领投了 1.2 亿美元 A 轮,Peter Thiel 等天使投资人也参与其中。随后,公司于 2025 年 12 月以 50 亿美元投后估值完成 5 亿美元融资,到 2026 年 6 月累计融资达 8 亿美元。最新公布的投资方包括 VentureTech Alliance、Jane Street、Hudson River Trading、Jump Trading、Two Sigma、Ribbit Capital 和 Stripes。Etched 称 VentureTech Alliance 的战略投资加深了其与 TSMC 的合作。
Hinton、Karpathy 和李飞飞等 AI 研究者,与 Druckenmiller、Thiel 等投资人出现在同一份名单上,显示专用推理芯片同时吸引了技术界和资本的关注。能否把这种支持转化为可交付的产品,还要看后续客户测试和量产进度。
速度能提高多少,还要看具体负载和客户测试
Etched 已从模拟阶段走到实物芯片和机架验证。公司称正在与客户测试产品,但此次公告没有给出可独立复核的 MLPerf 成绩或完整的生产部署数据。早期性能宣传与新系统实际表现之间,仍缺少公开的对照。
内存带宽是外部分析者关注的问题之一。科技分析网站 byteiota 根据早期 Sohu 的 144GB HBM3E、约 4TB/秒带宽规格,质疑公司相对 H100 的约 20 倍性能宣传。推理的瓶颈会随预填充、逐词生成阶段和并发规模变化,单看带宽不足以判断整套系统能快多少。Etched 此次提出的低电压计算和集群共享内存,正是分别针对吞吐量和延迟;具体收益需要在相同模型、负载和延迟要求下比较。
Luxor Technology 旗下研究机构 Hashrate Index 在 5 月的深度报告中将 Etched 描述为「独立 AI 芯片公司中最集中的架构赌注」,并列出了四项风险:性能声明缺少独立验证、模型架构变化可能削弱专用芯片的适用性、与 Nvidia 争夺 HBM 供应,以及从零建设软件生态,与已有多年积累的 CUDA 竞争。这份报告讨论的是当时的产品方案。
Uberti 本人曾在接受 TechCrunch 采访时坦承这一风险:「如果 Transformer 过时了,我们设计一颗新芯片。」但如 byteiota 所评论的,这是一个「多年的、数十亿美元的重来」。通用 GPU 通常更容易通过软件适应新模型,专用芯片则可能需要重新设计,成本取决于新架构与已有硬件的兼容程度。
Hashrate Index 对风险的表述尤为直白:「这些风险都不会使 Etched 的论点失效。它们只是意味着这 50 亿美元的估值假设 Etched 能在一个特定且狭窄的结果走廊中执行到位。」
Groq、Cerebras 和 OpenAI 也在推进专用推理硬件
Etched 并非孤例。2026 年上半年,其他推理硬件公司也在融资、上市或寻找合作伙伴:
- Groq 于 2025 年 12 月与 Nvidia 达成非独家技术许可协议,部分高管和员工加入 Nvidia。媒体报道交易金额约 200 亿美元,Groq 则保留独立运营。Nvidia 在 GTC 2026 上展示了结合 Groq LPU 与 Vera Rubin GPU 的 LPX 机架系统。Groq 此后又融资 6.5 亿美元,发展自己的推理云业务。
- 据 TechCrunch 报道,Cerebras 于 5 月 14 日上市,融资 55.5 亿美元,首日市值约 564 亿美元。这家采用 WSE-3 晶圆级芯片的公司,已获得 OpenAI 超过 200 亿美元的算力采购承诺,并与 AWS 达成硬件部署协议。
- 据 MarketWatch 报道,Broadcom 于 6 月 24 日公布了为 OpenAI 定制的推理芯片 Jalapeno。
接下来要把合同变成稳定运行的机架
从 Groq 的技术许可交易、Cerebras 上市,到 Etched 获得融资,降低推理成本正在吸引更多资金。不同公司的路线和交易性质各不相同,但客户最终购买的都是能够持续提供速度、成本或能耗优势的算力。
Etched 把更多资源投入专用架构,潜在收益与风险也更集中。即使 Transformer 未来 5 到 10 年仍是主流,芯片也需要在性能、软件适配和量产上证明自己;如果模型架构明显变化,公司还要应对硬件调整。此次公告未披露客户身份,公司正在验证首款机架产品,计划夏季开始交付。超过 10 亿美元的合同显示了客户需求,接下来要看实际交付和运行表现。