7 月 9 日,路透社援引一份 Meta 内部备忘录报道,代号 Iris 的新一代 MTIA(Meta Training and Inference Accelerator,Meta 训练与推理加速器)芯片计划于 9 月量产。公司还计划把基础设施部署规模从 2026 年底的约 7 吉瓦(GW)扩大至 2027 年的 14 GW。吉瓦表示功率规模,不能直接换算为计算性能。备忘录称,Iris 在约六周内完成测试,未发现重大问题。
Meta 于 2023 年首次公开介绍 MTIA。今年 3 月,公司又公布了四代芯片路线图:从已用于推荐排序训练的 MTIA 300,到计划于 2027 年大规模部署、重点优化生成式 AI 推理的 MTIA 500。9 月量产是后续型号的一项计划;现有报道没有明确 Iris 对应四款芯片中的哪一款。
博通参与设计,台积电制造,多家厂商供应关键部件
根据备忘录,博通(Broadcom)参与芯片设计,台积电负责制造;Meta 还与三星、SanDisk 和住友电工(Sumitomo Electric)签署协议,分别采购内存、闪存和光纤设备。自研芯片需要公司更直接地协调设计、制造、存储与互连环节。
Meta 与博通在 4 月宣布扩大合作,计划延续至 2029 年,支持多代 MTIA 的联合开发与部署。协议包含超过 1 GW 规模的首期承诺,是后续多吉瓦部署计划的一部分。
Meta 今年资本开支指引为 1250 亿至 1450 亿美元,包含融资租赁本金支付,其中很大一部分用于 AI 基础设施。公司同时采购 Nvidia 和 AMD 的 GPU;与 AMD 的多年协议被媒体估计有千亿美元级潜在规模。此外,Meta 与 Arm 合作开发 CPU,并通过 Amazon 旗下 AWS 使用 Graviton 芯片。MTIA 主要用于降低推荐排序、广告推理等任务的成本,让公司在组件短缺时有更多硬件选择。
四代 MTIA 逐步扩展任务范围,提高内存带宽
Meta 在 3 月的技术博客中披露了 MTIA 家族四代芯片的规格和部署进度:
- MTIA 300:已用于推荐与排序训练。模块热设计功耗为 800 W,HBM 带宽 6.1 TB/s、容量 216 GB,FP8 峰值计算吞吐量为 1.2 PFLOPS。
- MTIA 400:支持通用生成式 AI 任务,已完成实验室测试,正准备进入数据中心。Meta 称它是系列中首款同时追求成本优势、并在计算性能上对标领先商用产品的芯片。FP8 峰值吞吐量较 MTIA 300 提升 400%,达到 6 PFLOPS,HBM 带宽提升 51%。72 个加速器通过交换背板连接,形成一个可紧密协同工作的 scale-up 域。
- MTIA 450:重点优化生成式 AI 推理,HBM 带宽较 MTIA 400 翻倍至 18.4 TB/s,Meta 称其"远高于现有领先商业产品",但该处未点名比较型号。MX4 低精度峰值吞吐量为 21 PFLOPS,并引入 FlashAttention 硬件加速和混合低精度计算,计划于 2027 年初大规模部署。
- MTIA 500:HBM 带宽较 MTIA 450 再提升 50%,达到 27.6 TB/s,容量最高可达 512 GB,MX4 峰值吞吐量为 30 PFLOPS。它以 2×2 方式排列较小的计算 chiplet,另用 SoC chiplet 提供 PCIe 连接,计划于 2027 年部署。
按这份不到两年的产品路线图,MTIA 500 的 HBM 带宽约为 MTIA 300 的 4.5 倍。Meta 所说的计算吞吐量达到 25 倍,比较的是 MTIA 300 的 MX8 与 MTIA 500 的 MX4 峰值规格,精度不同,不能理解为相同任务提速 25 倍。公司称已具备约每六个月推出一代新芯片的能力。
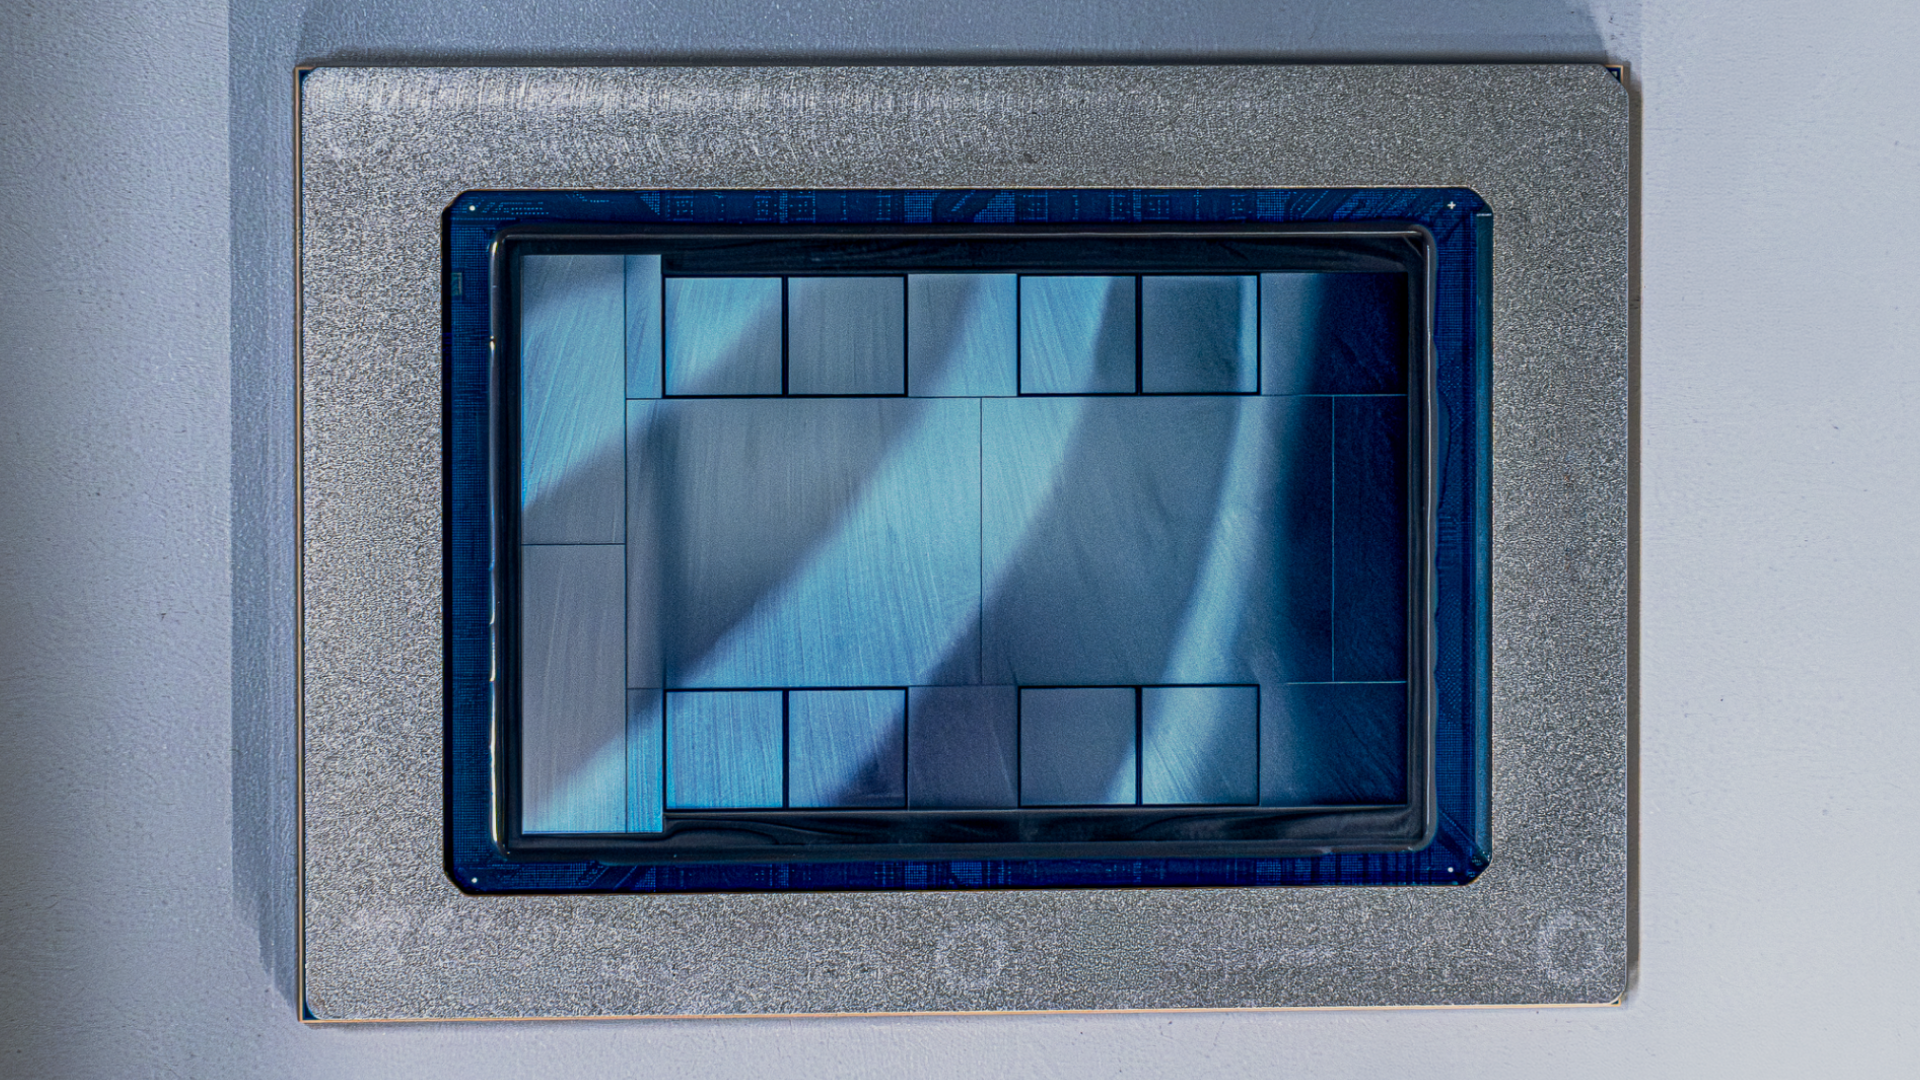
模块化 chiplet 设计是加快迭代的基础。不同 chiplet 可在不同工艺节点上制造,MTIA 400、450 和 500 则共用机箱、机架和网络基础设施,减少更换芯片时的系统改造。Meta 工程副总裁 Yee Jiun Song 在 3 月接受 CNBC 采访时说,定制芯片让公司可以在数据中心集群中"从每美元榨出更多性能"。
为推理增加带宽,并复用 PyTorch 软件生态
Meta 将 MTIA 450 和 500 定位为"推理优先":先围绕生成式 AI 推理优化,再根据需要支持训练等其他任务。公司认为,面向大规模预训练设计的 GPU,用于某些推理任务时可能有额外的成本和功耗,因此专用设计仍有优化空间。
Transformer 逐个生成 token 的解码阶段,往往会受到内存带宽限制,具体程度取决于模型和批处理方式。为此,MTIA 450 的 HBM 带宽较前代翻倍,MTIA 500 再增加 50%。Meta 还为两款芯片设计了低精度数据类型,称其能够在保持模型质量的同时提高计算吞吐量。
软件方面,MTIA 原生支持起源于 Meta 的 PyTorch,并接入 vLLM 插件、Triton 编译栈,硬件系统兼容 OCP 标准。Meta 表示,其生产模型可使用 torch.compile 和 torch.export 捕获、优化计算图,无需为适配 MTIA 专门重写模型,就能同时部署在 GPU 和 MTIA 上。公司此前已部署数十万颗 MTIA 芯片,用于旗下应用的非广告内容推荐和广告推理。
更多公司尝试专用芯片,成本优势还要看实际部署
Meta 推进 MTIA 的同时,其他 AI 公司也在增加专用芯片投入:
- OpenAI 在 6 月公布了与博通合作开发的首款推理处理器 Jalapeño;
- Anthropic 据 TechCrunch 7 月 2 日报道正在与三星讨论定制芯片开发;
- Amazon 的 Trainium 和 Google 的 TPU 已进入多代迭代;
- Etched、Cerebras、Groq 等芯片厂商也在开发或提供专用推理硬件。
前沿实验室和平台公司希望在采购 GPU 之外,获得更适合自身任务的硬件。专用芯片若能降低每次推理的总成本,就可能成为竞争优势;MTIA 450 的带宽规格显示了设计重点,实际性价比还要结合功耗、利用率、软件效率和研发投入判断。
部署进度也需要分开看。按 Meta 3 月披露的状态,四代新芯片中 MTIA 300 已投入使用,400 完成实验室测试,450 计划于 2027 年初大规模部署,500 则计划在 2027 年部署。从芯片量产到大规模承担新增的生成式 AI 推理任务,还需要封装、系统集成、软件调优和产能爬坡。14 GW 的基础设施目标也需要相应电力和数据中心,现有备忘录报道没有详细说明供电来源和选址进展。
MTIA 的意义在于,让 Meta 能围绕自身的推荐和生成式 AI 任务设计硬件,并继续配合外购芯片使用。9 月量产计划能否落实、后续型号能否以较低成本稳定运行,将决定这笔投入的实际回报。

