把机器人想象出的未来画面掺入强噪声,动作预测变化不到 1%;把两帧未来表示的时间顺序倒过来,同一批策略在分布外测试中的成功率却下降 24.24 至 32.37 个百分点。
这是三星 Robotics eXperience、三星北京研究院等团队在 2026 年 9 月 21 日提交的一项受控研究。研究者没有再造一个追求榜单成绩的完整系统,而是分别比较 6 种视频—动作因果结构、8 种视觉表示和 4 类训练目标,再直接干预模型生成的未来表示。结果把世界动作模型的焦点从“未来画得有多像”推向了一个更具体的问题:未来信息以什么时间顺序进入动作决策。
这个区别关系到一笔真实的工程账。世界动作模型通常在训练或推理时预测未来视觉状态,希望机器人先理解世界怎样变化再行动;视频去噪也会增加延迟。Fast-WAM 此前通过另一组受控实验发现,保留视频联合训练、但在推理时跳过显式未来生成,成绩仍接近“先想象、再执行”的变体。新研究没有推翻这个结论,而是进一步说明:当动作确实能够读取未来表示时,真正发挥作用的未必是精确像素,而可能是这些表示携带的时间结构。
同一批策略里,只把两帧未来表示倒过来
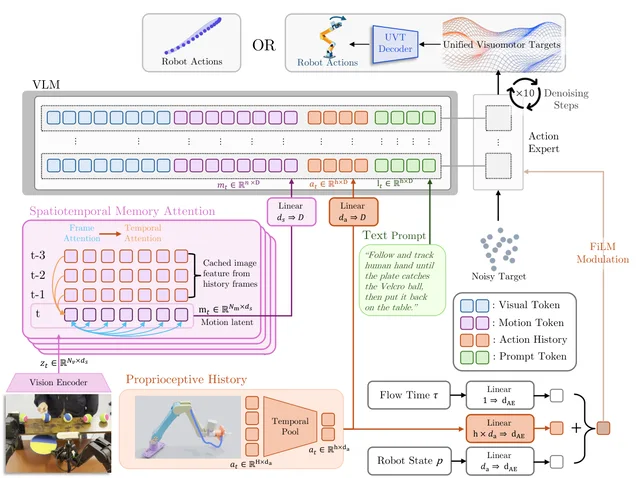
论文先比较六种信息流:视频与动作各自预测、视频读取动作、动作读取视频、双向读取、联合生成,以及按时间交错生成。分布外的 LIBERO-Plus 测试包含物体布局、相机视角、机器人初始状态、语言、光照、背景纹理和传感器噪声等变化。允许动作读取未来视频的 Joint 与 Bidirectional,相比各自匹配的控制组高出 16.14 和 14.93 个百分点;在同分布的 RoboCasa-GR1 上,它们反而低 2.33 和 4.00 个百分点。
不同模型之间的比较只能说明相关性。为了确认推理时的未来表示是否真的改变动作,研究者转而干预已经训练好的 Joint 与 Bidirectional 策略,其他条件不动。
第一种干预把每个未来位置与固定噪声混合,强度最高为 0.50,同时保留各通道的空间均值和方差。第二种干预在去噪过程最后 25%、50% 或 100% 的步骤里,交换两个未来位置;当前观测帧始终不变。最强内容干预造成的动作预测变化不到 1%,成功率没有实质变化。最强时间倒置则让 RoboCasa-GR1 成功率下降 6.08 至 11.08 个百分点,让 LIBERO-Plus 下降 24.24 至 32.37 个百分点;后者的动作预测本身也变化 12.79% 至 14.36%。
这项干预支持的不是“未来内容没有用”,而是一个更窄也更有用的判断:在这两个能读取未来表示的策略、两帧预测范围和指定扰动方式下,动作更依赖未来槽位的先后关系,而不是被保留统计量后的精确内容。对系统设计者而言,继续提高生成画面的视觉保真度,未必比保证时间索引和因果路径更值得预算。
时间结构放进哪里,决定它是先验还是包袱
研究的第二组实验解释了为什么“时间重要”不能简单等同于“越早编码越好”。八种视觉表示被分成两类:DA3、VGGT-Ω、V-JEPA、Qwen3-VL 视频模式和 Video-VAE 会跨帧联合编码;DINOv3、SAM3 与 Image-VAE 则逐帧编码,把时间整合留给后面的策略网络。
在熟悉分布的 RoboCasa-GR1 上,五种跨帧表示的成功率全部高于三种逐帧表示;到了 LIBERO-Plus,最高的两项反而来自逐帧的 DINOv3(74.33%)和 Image-VAE(73.74%),跨帧表示中的最高值 DA3 为 72.10%。线性探针也出现同样的反转:跨帧表示在 RoboCasa-GR1 的各层更容易解码出专家动作,逐帧表示在 LIBERO-Plus 的各层领先,直到最后一层差距才接近消失。
研究者随后把同一轨迹里的历史帧或当前帧替换成更早的观测。三种替换下,跨帧表示对应策略的成功率分别下降 8.00、7.20 和 4.00 个百分点,逐帧表示只下降 2.67、1.55 和 0.90 个百分点。论文据此提出一种机制解释:冻结的视觉编码器提前压入跨帧关系,能在熟悉轨迹上提供强动作先验;测试时的时间关系一旦变化,这个先验也更容易变成脆弱依赖。逐帧表示保留局部视觉证据,让下游策略按当前上下文重新组织时间,因此牺牲部分同分布成绩,换来更小的分布外损失。
视频训练有价值,多目标同时上却会互相干扰
训练目标实验把行为克隆(直接从观测与指令预测动作)作为基线,再分别加入逆向动力学、前向动力学和视频生成。RoboCasa-GR1 上,47.58% 的行为克隆基线最好,所有辅助目标组合都更差;前向动力学单独加入后只有 11.62%。这说明在熟悉分布里,额外任务会分走模型容量,而不是自动带来更好的控制。
LIBERO-Plus 上方向相反。视频生成把行为克隆的成功率从 77.96% 提到 81.22%,增加 3.26 个百分点;前向动力学只增加 0.05 个百分点,逆向动力学还略降 0.46 个百分点。四类目标从训练开始就同时加入时为 77.98%,几乎回到基线。先用行为克隆和视频生成完成前 80% 的训练,再在最后 20% 加入两种动力学目标,成功率达到 83.15%:比行为克隆高 5.19 个百分点,也比从头联合所有目标高 5.17 个百分点。
这里的增量与前面的干预并不矛盾。视频生成可以在训练阶段迫使模型保留视觉与时间信息,而推理阶段的动作未必需要一幅内容精确的未来画面。真正影响结果的是时间信号通过哪条路径进入策略,以及辅助目标在表示尚未稳定时是否抢占了学习方向。
真机数据只验证了离线动作预测,闭环还没有答案
论文还使用 DROID 的真实机器人数据按任务语义划分训练、验证和测试集。DROID 本身包含 7.6 万条成功示范,覆盖 564 个场景和 86 类任务;但这项新研究没有让模型在机器人上闭环执行,而是比较留出数据上的逐动作元素误差与阈值准确率。
三个方向都复现了仿真中的排序,不过幅度有限:因果交错结构的 Accuracy@0.1 为 53.78%,无条件结构为 51.83%;逐帧 DINOv3 为 53.08%,跨帧 DA3 为 52.40%;行为克隆加视频生成是 51.84%,行为克隆基线是 49.94%。离线预测更准,不等于机器人在误差累积、接触失败和重新规划出现时完成任务的概率更高。
证据边界还包括:论文是未经同行评议的预印本;三条设计轴分别做受控比较,并不是把 6 种因果结构、8 种表示和 4 类目标组成完整的 192 组全因子实验;主要结论来自中等规模仿真,时间干预只交换两个未来位置;论文没有给出代码链接,正文提到的详细附录也未包含在当前 8 页 PDF 中。另一项 WAM 鲁棒性研究同样发现,不同扰动下的优势并不统一,而且即便省去未来生成,Fast-WAM 的推理仍比其对比的 π0.5 慢约 3 倍。时间结构不是免费的万能组件。
这项研究真正改变的,是世界动作模型的优化顺序。下一轮验证不该只问生成画面更不更清晰,而应先检查三个可测变量:动作能否读取未来表示、时间索引被扰动后性能掉多少、辅助目标在训练的哪个阶段加入。只有当这些结果在公开代码、更长预测范围和真实机器人闭环中复现,才能判断“想象未来”究竟是控制所需的机制,还是一种昂贵的训练支架。