评估机器人策略,通常意味着让机器人反复执行任务:摆好物体、启动策略、监控硬件、记录成败,再重置场景。2026年9月3日公开的 R2S-Eval 试图把其中可重复的部分搬进仿真:先按真实工作台校准 Isaac Sim,在仿真中运行六种视觉—语言—动作(VLA)策略,再让视觉语言模型(VLM)比较完整执行视频,最后汇总成策略排名。
在一台 SharpaNorth 双臂机器人和七个桌面操作任务上,作者报告的仿真成功率与实机成功率平均相差 2.13 个百分点,六种策略的总体顺序相同。这支持把仿真当作这一组实验的排序代理,但还不支持用它替代广泛的实机测试。更需要纠正的是,论文 Table IV 把八个 VLM 与人工偏好的平均一致率写成 91.9%;逐行复算应为 90.9%。
真实场景先按机器人、相机和物体校准,再分别训练两套策略
R2S-Eval 先校准会影响策略行为的条件:机器人几何与关节限制、控制接口、四路相机、物体模型、桌面场景、任务定义和初始位置。作者用遥操作采集 3525 条真实轨迹,再把动作序列放入仿真回放;系统会在估计物体位置附近自动扰动,最多尝试八次,以找到满足规则的成功回放,最终得到 3445 条仿真轨迹,回放成功率为 97.8%。
这里不能把“回放相似”理解成“策略跨域不变”。论文明确写道,真实侧策略与仿真侧策略分别用真实数据和仿真数据训练,只共享同一预训练起点、任务、输入输出接口和各模型的训练配方。摩擦、柔顺性和传感噪声等差异没有被消除;R2S-Eval 比较的是两组独立训练策略是否保留相对排名。
这条边界也解释了方法与先行工作的差异。PolaRiS 用神经重建生成高保真场景,并通过与目标任务分离的仿真数据共同训练来提高 real-to-sim 相关性;WPE 则用动作条件视频世界模型产生 rollout,再由 VLM 判断二元成功,但其论文也发现世界模型会低估分布内动作、明显高估分布外动作。R2S-Eval 没有用生成视频替代物理仿真,它的新增部分是让 VLM 比较两段完整行为,而不是只判一次成败。
42个组合平均差2.13个百分点,相近策略仍难排序
作者在每个“策略×任务”组合上进行 20 次实机试验和 200 次仿真试验,即总计 840 次实机 rollout 与 8400 次仿真 rollout。按论文 Table II 的 42 对成功率复算,绝对差合计 89.5 个百分点,平均为 2.13095 个百分点,与论文的 2.13 一致;最大差为 7 个百分点。
| 策略 | 实机平均成功率 | 仿真平均成功率 |
|---|---|---|
| X-VLA | 65.7% | 64.9% |
| π0.5 | 63.6% | 64.5% |
| π0 | 53.6% | 58.1% |
| OpenVLA | 7.1% | 5.3% |
| NORA-Long | 4.3% | 3.7% |
| SmolVLA | 2.1% | 1.6% |
六个策略在两侧保持相同总体顺序,最强三种与其余三种之间还有明显间隔。不过,X-VLA 与 π0.5 的实机平均成功率只差 2.1 个百分点;每项实机成功率又来自 20 次试验,单次成败会让单任务结果变动 5 个百分点。论文也观察到,不同 VLM 对这两种策略会给出相反的先后。因而“总体顺序相同”更能支持识别大差距,不足以证明相近策略之间已经排得稳定。
视觉模型看完整执行过程,再汇总成策略排名
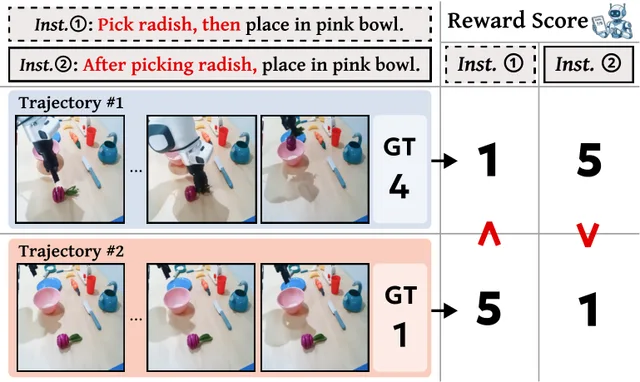
对每一对策略,系统从相同任务和初始条件下抽取两段视频。VLM 先分别描述动作平滑度、时间连续性、任务进展,以及画面可见的接触和用力控制,再在隐藏策略身份、随机交换 A/B 位置后选出较好的一段。多次比较形成胜负矩阵,Bradley–Terry 模型再把成对偏好压缩成每个策略的强度分数和排名。
这比二元成功率多保留了一层信息。论文案例中,两段成功视频分别是一次完成与抓取失败后重试;两段失败视频分别是已经伸手尝试操作与原地小幅振荡。VLM 都偏向前者。它衡量的是可见执行质量,不等同于安全性、物理受力或任务成功准确率。
在七个实机对应任务上,八个 VLM 的策略排名与实机成功率排名之间,平均 Spearman 相关系数为 0.957;分数与实机成功率的平均 Pearson 相关系数为 0.978。两项数字都只基于六个策略,且后三种策略几乎都失败,较大的档位差会让相关性更容易变高。论文还在 LIBERO 的 40 个任务上做了仿真实验;LIBERO 原始基准共有 130 个语言条件操作任务,因此这里同样只是选取其中四组各十项任务来验证评判流程。
八项一致率平均为90.9%,论文汇总行多了1个百分点
人工验证使用两套各 200 组的视频对:LIBERO 一套、real-to-sim 一套。三名标注者独立选择较好的执行,多数票作为参考;每套都刻意放入 66 组“都成功”、67 组“都失败”和 67 组“一成一败”。real-to-sim 条件下,八个 VLM 的一致率依次为 90.0%、91.5%、92.0%、88.5%、90.0%、92.0%、93.0% 和 90.5%。
这八项的算术平均为 90.9375%,按一位小数应写成 90.9%,而不是 Table IV 汇总行的 91.9%。论文正文没有提供另一种加权公式,附录又说明每个 VLM 使用同样 200 组视频对,因此 91.9% 不能按现有表格复现。它也不能被解释为任务成功识别率:这个指标衡量的是 VLM 与三人多数票在成对偏好上的一致程度。三名标注者在 real-to-sim 样本上全票一致的比例本身只有 80.0%,说明“哪段行为更好”并非总有唯一明显答案。
另一个偏差来自视频位置。作者把同一批 real-to-sim 视频对调换 A/B 后再问一次,八个 VLM 平均有 91.5% 保持选择不变;对表现接近的视频,模型略偏向 A。随机位置能让这种偏差在大量比较中部分抵消,却没有消除单次判断的不稳定。
仿真省下重复硬件操作,前期建模和训练成本仍在
论文的人工成本曲线统计了硬件执行、物体初始化与重置、监控和记录成功结果的时间,没有计入一次性的真实数据采集、物体扫描与手工建模、任务校准、两套策略训练、仿真计算和 VLM 推理。R2S-Eval 的确能让后续试验数增加时不再同比增加机器人操作时间,但前提是团队已经为目标平台和任务建好可信代理。
截至论文首版,实验还只有一台机器人、七个刚性物体桌面任务、六种策略,作者也没有在论文页提供 R2S-Eval 自身的代码或数据入口。移动操作、长程任务、柔性物体、碰撞安全以及换机器人后的排名保真度,都没有被验证。
因此,团队采用这类方法时应分开验收三层结果:先用少量配对实机试验检查仿真能否保持策略档位,再用人工抽样审计 VLM 的偏好与位置偏差,最后才扩大仿真 rollout。下一项真正关键的指标不是更多仿真次数,而是换平台、换任务后,排序相关性和相近策略的置信区间是否仍能成立。