把 OpenVLA-OFT 放在整洁的开局,它在四套 LIBERO 任务中平均完成了 97.1%;把同一个模型放到抓取失败、物体被碰歪后的残局,论文主图中的平均完成率约为 23.1%。
模型没有突然忘记怎样抓东西。变化在于,评测把起点从“沿着熟悉的任务继续做”挪到了“先判断刚才弄乱了什么,恢复状态,再把原任务做完”。9 月 4 日提交的预印本 LIBERO-RECOVER,用模型自己在仿真执行中留下的失败状态,补上了标准机器人基准一直绕开的这一段。
把评测起点移到模型犯错之后
标准 LIBERO 提供 130 个语言指令驱动的机械臂任务,覆盖空间关系、物体识别、目标条件和长任务组合。每次评测从预先记录的合法初态开始,机器人在稀疏奖励下完成目标就算成功。这套协议擅长回答“模型能否从干净起点执行任务”,不负责回答“执行途中出错后能否继续”。
LIBERO-RECOVER 保留原任务和目标,让多种视觉—语言—动作模型及世界动作模型先完整执行。失败不是研究者凭空把杯子挪走,而是模型在 MuJoCo 仿真里真的抓空、碰撞或移动了错误物体。研究团队保存失败前轨迹、失败后的模拟器状态和原目标,再要求受测模型从这个残局继续。
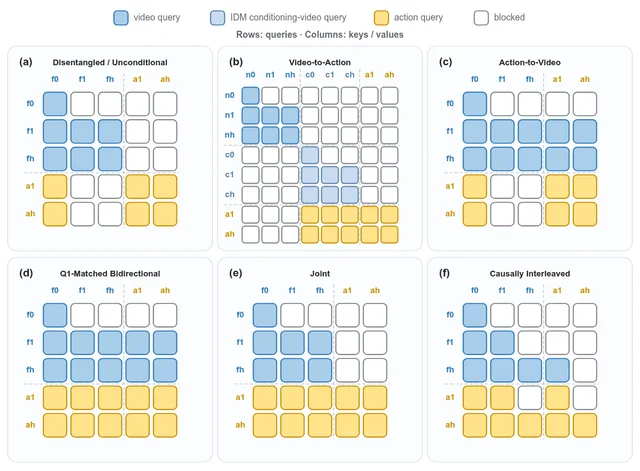
恢复难度被分成四级:目标物没变,重试动作即可;物体位置小幅变化,需要调整动作;目标物状态已被破坏,要先把它复原;无关物体堵住后续流程,要先恢复环境。前两级主要考察下一步动作,后两级要求模型记住原计划、识别状态差异,并理解物体之间的依赖关系。
场景筛选也引入了一层模型判断。论文称 Qwen3.5-27B-Instruct 根据整段视频定位失败时刻,再判断后果和恢复等级;正文没有报告这些标签经过多少人工复核。四名人工操作员随后用 SpaceMouse 为 413 个失败场景采集了 3184 条恢复轨迹,用于微调模型。
局部重试还能做,恢复环境几乎做不到
论文评测了 OpenVLA-OFT、π0、π0-FAST、GR00T-N1.5、Wan2-Policy 和 Cosmos-Predict2-Policy 六种模型。每个任务运行 10 次,初始物体位置有轻微扰动,最长执行时间按人工完成时间和任务难度设定。
结果的断层出现在“动作纠正”跨向“状态恢复”时。六种模型在四套任务中的一级、二级恢复普遍高于三级、四级;在 LIBERO-100 的四级环境恢复中,表格里的六个成功率全部为 0。这里要求机器人发现原任务之外的障碍,先处理障碍,再回到原计划,单靠重复最后一个动作无法过关。
标准榜单的顺序也没有延续到恢复任务。以 LIBERO-100 为例,Wan2-Policy 的标准成功率比 GR00T-N1.5 高 14.4 个百分点,进入对应失败状态后反而低 5 个百分点。高分模型学到的是在合法初态附近稳定执行;失败把它带到示范数据较少覆盖的状态,原来的领先幅度不再提供同等优势。
3184条恢复示范补回4.6分,没有带动标准成绩
研究团队把恢复示范与原 LIBERO 数据混合训练,结果首先改善了“从残局出发”的能力。OpenVLA-OFT 的平均恢复成功率在同一组训练实验中从 20.8% 升到 25.4%,增加 4.6 个百分点;GR00T-N1.5 从 17.8% 升到 21.2%。
这批数据没有同步抬高标准任务成绩。OpenVLA-OFT 从 97.1% 小幅降到 96.6%,GR00T-N1.5 从 86.5% 升到 87.2%。给模型看过恢复动作,解决的是“已知自己处在失败状态时怎样行动”;普通执行中,模型还要在线发现失败已经发生,并决定何时放弃原动作序列。两步不是同一个学习问题。
论文另一项实验印证了这个区别:只给 OpenVLA-OFT 当前残局画面,平均恢复成功率为 20.8%;再补一张任务初始画面,成绩升到 26.8%。初始画面像一张案发前照片,让模型能够比较“本来是什么样”和“现在被改成什么样”。恢复能力因此不只取决于动作生成,还取决于模型是否保留足够的时间上下文来识别状态变化。
场景来自仿真执行,六模型主结果还不能一键复现
LIBERO-RECOVER 所说的“真实执行失败”,意思是失败由受测模型自然造成,而非研究者预先注入;所有主实验仍发生在 LIBERO 的 MuJoCo 仿真环境,不能直接换算成真机故障率或部署安全性。此前的 FailSafe 已在 ManiSkill 中合成失败并生成可执行纠正动作,Dream2Fix 也用世界模型合成失败—修复样本并做真机闭环测试。LIBERO-RECOVER 的增量在于把模型自然造成的仿真残局做成一套独立评测,而不是首次让机器人学习恢复。
公开材料已经给出可运行的起点:GitHub 仓库包含场景评测脚本,ModelScope 上的恢复示范和场景资产可下载,数据条目标注 Apache 2.0。当前仓库的主说明要求用户自行提供 StarVLA 检查点,根目录没有许可证,也没有论文六种模型的检查点、逐次结果日志或完整制图数据,尚不足以从零复现主表。
论文内部还有两处需要作者澄清的口径。正文和项目页写有 2178 个恢复场景,项目分布图中心却标注 2117;主对比图按四套任务复算出的 OpenVLA-OFT 平均恢复率约为 23.1%,后续训练表把基线写成 20.8%,差异主要来自 LIBERO-100 一项分别为 19.3% 和 10.3%,文中没有说明是否更换了样本或设置。因此,混合训练带来的 4.6 个百分点提升只能在那张训练表内部比较,不能与主图直接拼接。
标准 LIBERO 的近满分没有失效,它只是回答了一个更窄的问题。LIBERO-RECOVER 把机器人评测向前推进了一步:下一道门槛不是把干净开局再刷高零点几个百分点,而是让模型及时承认计划已经失效,找出被自己改变的状态,并在可复现的协议里把残局收回来。