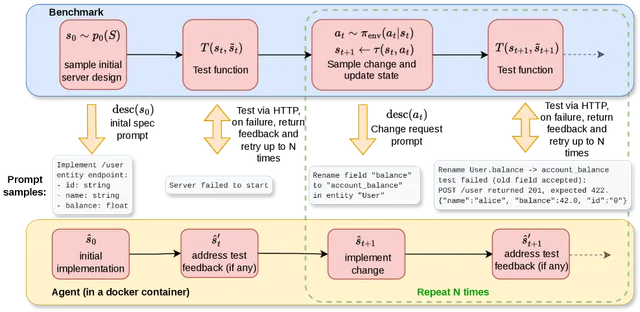
同一台机器人、同一段抓起萝卜再放进粉色碗的视频,只换了任务指令的句式,一套视觉语言模型给出过 1 分和 5 分两个相反答案。1 分代表失败,5 分代表完成。9 月 4 日提交的 RoboRMBench 论文把这种现象从提示词轶事变成一项专门评测:奖励模型不仅要看懂机器人做得对不对,还要证明自己不会把说法当成目标本身。
这一区别会进入训练闭环。强化学习会增加高奖励轨迹被继续采纳的概率;当奖励随措辞漂移,同一行为可能同时收到鼓励和否定。RoboRMBench 因此提出一个比平均误差更靠前的问题:面对等义指令,模型能否先保持判断一致?
2390 条轨迹,只改变任务怎么说
RoboRMBench 没有重新拍摄机器人视频,而是从 RoboRewardBench 的测试集取出 2390 条真实机器人轨迹。后者汇集 Open X-Embodiment 与 RoboArena 数据,覆盖 14 种机器人形态,并由人工给每段轨迹标注 1 至 5 的完成进度。原数据中 1 分样本偏多,研究团队先下采样,使五档进度大致均衡。
随后,团队用 GPT-5 生成三类英文改写:替换近义词、调整句法,以及在“动作过程”和“目标状态”之间换一种描述角度。三个模型——Gemini 3 Flash、Claude Sonnet 4.6 和 DeepSeek-V3.2——分别检查改写是否偷换了任务含义;任何一个模型提出异议,候选就被删除。少于五条有效改写的轨迹也被排除。最终留下 21673 条改写,其中词汇替换、句法调整和动作—目标转换分别覆盖 613、943 和 834 条轨迹。
这套过滤并非只靠模型自证。研究者抽查 210 条候选,由两名人工标注者判断是否等义;人工标出的 25 条问题改写中,模型组合拦下 24 条,召回率为 96%。它还额外拦下 17 条人工没有标错的表达,说明过滤策略宁可少留,也尽量不让语义变化混进稳定性测试。
平均误差相近,成败判断仍可能相反
论文把 1、2 分归为失败,4、5 分归为成功,3 分作为中间状态。它用两个指标拆开观察:Score Crossing Rate(SCR)统计一组等义说法中是否同时出现失败与成功;Flip Rate(FR)统计改写相对原始指令有多少次改变成败判断。平均误差(ME)则继续衡量预测进度与人工标签相差多少。
三者不能互相替代。Claude Sonnet 4.6 在词汇替换组是最稳定的通用模型,SCR 为 5.1%,平均误差却接近 1 分;Gemini 3 Flash 的平均误差更低,为 0.681 分,SCR 却达到 27.1%。一个模型可以稳定地偏离人工答案,也可以平均看来更准、遇到等义说法却反复改判。
最明显的翻转出现在动作—目标转换组。Gemini 2.5 Flash Lite、Gemini 2.5 Flash 和 Llama 4 Scout 的 SCR 分别为 60.7%、52.1% 和 55.7%。换句话说,在各自所测轨迹中,超过一半至少出现过一次“同一行为,一种说法判失败、另一种判成功”。论文另用最严格的 1 分对 5 分口径复算,直接跨越两个极端的情况减少,却没有消失。
更大的模型和更长的推理没有形成稳定保险
论文在 Qwen3-VL 和 Gemma 3 家族内比较不同规模,没有看到参数增加带来单调改善。显式推理的结果同样依模型而变:它改善 GPT-5.1,却让 Claude Sonnet 4.6 的稳定性下降;Qwen3-VL 235B 与 Gemini 3 Flash 的主对照中,启用推理后 SCR 反而上升。这里能支持的结论很具体:通用能力、参数规模和“会写推理过程”都不能替代等义稳定性测试。
另一项对照排除了大部分随机采样噪声。主实验对每个“轨迹—指令”组合只调用一次模型,而且不同模型沿用各自提供方的温度与采样配置。研究者又在 300 个分层样本上把同一输入重复调用十次:所测模型的重复调用标准差平均为 0.09,跨改写标准差为 0.52。措辞带来的变化明显大于同一句话重复请求的波动,不过这些数字描述的是当前 API 与模型版本下的部署表现,不是完全确定性推理环境中的固有常数。
论文关于三类改写强弱的比较也有一处重要限制:三类策略最终保留的轨迹数量不同,并非在完全相同的轨迹集合上逐项配对。因此,结构和视角变化组往往更不稳定是一项一致观察,尚不能把全部差异严格归因于语言改写幅度。
专用监督比参数规模更接近问题本身
两个专门训练的 RoboReward 模型给出了反例。RR-4B 在三组测试中的 SCR 为 3.4%、7.2% 和 8.6%;RR-8B 为 3.4%、10.2% 和 11.4%,同时取得全表最低的平均误差。这两个模型只有 40 亿和 80 亿参数,训练时直接看过机器人轨迹与进度奖励。它们没有证明奖励模型已经可靠,却说明问题并非“视觉语言模型天生无法做奖励”:对准轨迹和奖励的监督,比继续放大通用模型更直接。
RoboReward 此前已经展示过这种专用监督的价值。它把成功占多数的机器人示范补入错误目标和截断轨迹,训练出的 8B 模型在 RoboRewardBench 上把平均绝对误差降到 0.665,并在两项真实机器人强化学习实验中超过若干通用奖励模型;DeepLearning.AI 对该工作的独立解读也把关键增量归结为经验证的失败与部分进度样本。RoboRMBench 向前追问了一步:即使平均答案够准,这个答案是否会被无关的语言表面形式带走?
研究团队还尝试了两种修补。推理时为每条种子指令再生成五条等义表达并汇总分数,可以降低 SCR 与误差,代价是每次奖励都要多次调用模型。训练时给同一轨迹的等义指令加入方差惩罚,Qwen3-VL 4B 在动作—目标转换组的 SCR 从 20.0% 降到 5.7%,平均误差从 1.020 降到 0.372;这项结果来自同一论文的受控实验,尚待独立复现。
奖励模型上线前,需要多一组不变性测试
RoboRMBench 的下游实验在每项任务的 20 条候选轨迹中,让奖励模型选出预测分最高的一条。11 个模型里,SCR 与选择遗憾值的 Pearson 相关系数为 0.882:越容易被改写触发矛盾的模型,通常选到的真实进度越低。这个离线相关性没有直接证明在线机器人会怎样学坏,却把语言不稳定与一次具体决策后果连接了起来。
评测边界也很清楚:全部指令都是英文,只测完整回合结束时的 1 至 5 分进度,没有覆盖逐步奖励、多语言或真实在线训练;托管模型使用提供方接口,版本与采样行为会变化。论文 v1 给出了提示词、筛选流程和主要结果,却没有提供 RoboRMBench 专属的数据下载或评测代码地址,外部团队暂时无法从原始样本复算整张表。
因此,团队在接入视觉语言奖励模型前需要新增的不是一句更精巧的标准提示词,而是一组围绕真实任务制作的等义表达。平均误差回答“通常差多少”,改写不变性回答“换一种正常说法会不会改变训练方向”。只有两项都过关,语言才是在描述目标,而不是悄悄成为奖励函数的一部分。