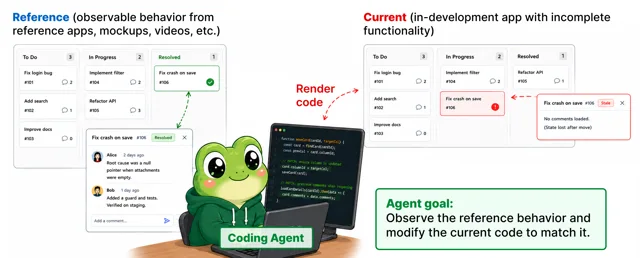
在 Cursor、Claude Code 或 Codex CLI 中连续提出修改请求,已经成为一类常见开发方式:先生成代码,再增加功能、调整字段或修改约束。同一个会话可能持续几十轮,Agent 既要完成新需求,也要保留此前已经实现的行为。
AWS Agentic AI 团队提出的 StaminaBench 专门测试这种连续修改。在不提供基准测试反馈、也不允许按失败结果重试时,最佳受测组合平均通过 6.2 轮。加入详细反馈与重试后,通过轮数明显增加。
在同一 REST API 项目上连续提出 100 轮修改
AWS Agentic AI 团队(Vlad Sobal、Shuo Yang 等)在 2026 年 6 月发布了 StaminaBench——一个专门测量编程 Agent「耐力」的基准测试。与 SWE-Bench 等「单次任务成功率」指标不同,StaminaBench 模拟连续修改项目的一种场景:Agent 需要在一个持续进化的代码库中,连续处理 100 轮修改请求,记录首次未通过测试前完成了多少轮。
具体来说,StaminaBench 让 Agent 实现一个 REST API 服务器,然后通过从结构化操作空间采样的变更序列(添加实体、重命名字段、修改约束条件、增加分析端点等)不断提出新的修改需求。每轮修改后,Agent 的代码必须通过一套自动生成的 pytest 测试套件。Agent 运行在隔离的 Docker 容器中,基准测试仅通过 HTTP 端口与它通信——完全黑盒、语言无关。
每个配置使用 20 个独立场景,每场景含 1 轮初始实现和 100 轮修改,最多 2,020 轮交互。较强模型完成较多轮次后,代码库可达到约 6,000 行。测试用例完全由程序生成;变更序列则既可由规则采样,也可由 LLM 在受约束的操作空间中采样。
不提供反馈与重试时,平均通过轮数较少
研究者首先关闭基准的反馈与重试循环:Agent 提交代码后运行评测测试,一旦失败,该场景就终止。Agent 仍有工具和 shell 访问能力;这里关闭的是评测端把失败信息交回 Agent 的环节。
实验覆盖 7 个开放模型与 6 种 Agent 运行框架(harness)中的 26 个组合,并非所有模型与框架两两配对。无反馈时,最佳组合 GLM-5 + OpenCode 平均通过 6.2 轮。这是 20 个场景的平均值,不是每次运行都在第 7 轮前结束。任务规格较明确,但每轮仍可能包含多项相互影响的修改。
这 7 个被测模型的总参数规模从 24B 到 1T:Devstral 2(Mistral,123B)、Devstral Small 2(24B)、GLM-5(744B/40B MoE)、Kimi K2.5(Moonshot,1T/32B MoE)、Nemotron Super(NVIDIA,120B/12B 混合架构)、Qwen3-Coder-Next(阿里,80B/3B MoE)和 Qwen3.5-122B(阿里,122B/10B MoE)。六个 harness 则包括三大开源框架(OpenCode、Mini-SWE、OpenHands)以及三个模型厂商自研 harness(Mistral Vibe、Kimi CLI、QwenCode)。
结果表明,即便需求描述明确,连续修改也容易引入实现错误。研究者观察到,Agent 有时忽略早期约束,并讨论了长上下文与压缩过程丢失信息的可能影响。实验没有把所有错误都归结为同一种原因。
详细反馈配合重试,使最佳组合达到平均 57 轮
随后,研究者开启重试循环:测试失败时,把失败信息反馈给 Agent,允许在当前轮次最多重试 2 次。
所有 26 个 model × harness 组合均显著改善(Wilcoxon 符号秩检验,Holm 校正后 p < 0.05)。最强的 GLM-5 + OpenCode 组合从平均 6.2 轮增至 57.0 轮,约为原来的 9 倍。而如果将重试预算从 2 次扩展到 10 次,GLM-5、Kimi K2.5、Qwen3.5-122B 等较强模型的收益主要出现在前 3–5 次尝试,之后趋于平台期。
研究者还比较了反馈的详细程度:
- 详细反馈(具体断言失败信息):GLM-5 + OpenCode 达到 57.0 轮
- 中等反馈(仅告知每个测试通过/失败,无错误细节):通过轮数下降
- 最小反馈(仅告知「测试失败」,无任何细节):GLM-5 降至平均 10.7 轮,Qwen3.5-122B 从平均 39.4 轮降至 2.8 轮
在 OpenCode、每轮最多重试 2 次的设置下,所有模型使用最小反馈时的平均通过轮数均低于 11。 详细反馈与最小反馈之间的差距在 6/7 的模型上达到了统计显著性(p < 0.05)。这些结果显示,精确的错误信息有助于 Agent 定位并修复问题。
同一模型换运行框架,通过轮数也会改变
模型之外,负责工具调用、上下文管理和错误恢复的运行框架,也明显影响多轮表现。
以每轮允许重试 2 次的 GLM-5 为例,OpenCode 平均通过 57.0 轮,Mini-SWE 为 15.1 轮,OpenHands 为 8.7 轮;OpenCode 的平均通过轮数分别为后两者的约 3.8 倍和 6.6 倍。Devstral Small 2、Nemotron Super 等模型在多种框架下的分数都较低。框架的影响很大,但这组实验不足以给模型与框架的重要性排出通用顺序。
同时,模型厂商自研的 harness 并不一定能带来优势。QwenCode(阿里为 Qwen 系列提供的 harness)在两个 Qwen 模型上的表现显著劣于 OpenCode(Qwen3-Coder-Next p=0.014,Qwen3.5-122B p=0.011)。OpenHands 则是 6/7 模型的最差 harness。
OpenCode 在所有 7 个模型上都是最佳或与最佳结果没有显著统计差异的选择。Mini-SWE 虽然只暴露一个 bash 工具接口,表现仍有竞争力。这里比较的是论文指定的框架版本与配置,换用其他版本或任务后,排名可能变化。
错误既来自实现偏差,也来自工具和会话故障
研究者还分析了失败类型。研究团队让一个 Agent 分析实验日志,将每次失败分类到预定义的类别中。
无重试模式下,常见问题是「实现偏差」:Agent 没有严格遵循要求,数据验证规则过严或过松。例如,字段要求非空,代码却接受了 null。README.md 始终可以查阅,Agent 仍可能遗漏其中的约束。作者认为,长会话中的信息保留与压缩是值得进一步检查的因素。
有重试模式下(R=10),基础设施问题变得更加突出:Agent 使用错误的工具调用格式、调用过于宽泛的 pkill 误杀自己的 harness 进程、在上下文压缩期间调用工具导致 OpenCode 报错。OpenHands 的严格循环检测逻辑在 Agent 连续四次发送相同消息时触发,错误状态污染整个会话,导致后续请求无法正常执行,场景终止;GLM-5 + OpenHands 的 20 个场景中有 13 个遇到这一问题。
这些案例说明,多轮编程不仅涉及代码生成,还包括工具调用规范、错误恢复和上下文管理。StaminaBench 因而可以用于比较整个 Agent 系统,而不仅是底层模型。
多轮评估消耗数十亿输入 token
多轮评估的代价不菲。论文披露,GLM-5 + OpenCode 一个 20 场景的 sweep 消耗了 45 亿输入 token 和 750 万输出 token。假设闭源模型使用同样的 token 数量,按论文列出的当时单价估算,Claude Sonnet 4.6 每个配置约需 $13,600,GPT-5.5 约需 $22,700——这是作者未开展完整闭源模型对比的原因之一;实际费用还会受到缓存、生成长度和通过轮数影响。
多轮可靠性需要结合反馈、框架和任务评估
这项基准为连续使用编程 Agent 提供了三个观察角度。
第一,单次完成任务的能力不能直接代表长期可靠性。 在这项 REST API 测试中,无评测反馈时,最佳组合平均通过约 6 轮。每轮修改都可能影响此前的行为,回归测试因此比只检查新增功能更有价值。
第二,反馈内容比一句「失败了」更能帮助修复。 详细反馈下,GLM-5 平均通过 57.0 轮,最小反馈下为 10.7 轮;Qwen3.5-122B 则为 39.4 对 2.8 轮。把失败测试、期望结果和实际结果交给 Agent,可以为 CI/CD 中的自动修复提供更具体的依据。
第三,模型与框架需要一起比较。 同一模型在不同框架中的分数差距很大,不能只根据模型排行榜选择运行环境。上下文压缩、工具接口和故障恢复都应纳入多轮任务测试。
StaminaBench 的代码和预生成场景数据已在 GitHub 开源(amazon-science/StaminaBench)。目前结论来自 20 个 REST API 场景,更大的场景集和其他软件任务仍需验证。它提供的是一种测量连续修改可靠性的方法,而非所有编程 Agent 的统一对话轮数上限。