7 月 21 日,通义团队发布 Qwen-Image 3.0,将可接受的指令长度提高到 4.5K token。官方用一张九宫格图片展示变化:九个区域各自包含讲义、漫画或图解,中文、英文、公式和插画同时出现在一张画布上。团队称它由一次生成完成,描述这张图的指令就用了约 3.7K token。
制作课程讲义、知识卡片或产品说明时,用户可以一次写下更多正文和排版要求,让模型将多个信息区域安排在同一张画布上。生成的大图如何拆页、以什么尺寸发布,则影响读者能否看清其中的细节。
更长的指令,交代更多文字与图形关系
Qwen 并非到 3.0 才开始做信息图。2 月 10 日发布的 2.0 已支持 1K token 指令和原生 2K 图像,也已将生成与编辑合并到一个模型。海报、幻灯片和漫画,原本就在它的目标任务之内。2.0 官方介绍
按 token 计,3.0 公布的指令长度上限是 2.0 的 4.5 倍。增加的空间可以用于写明每个区域的文字、图形、位置和相互关系,把笼统的“做一张科普海报”展开成更具体的设计要求。
3.0 的九宫格样例展示了这些要求如何组合。左上是隧道安全漫画,上中是空间几何,下方还有银行内控流程和细胞结构。不同格子使用不同的排版方式:漫画用对话气泡,讲义用问题、推导和答案,结构图用箭头连接标签与对象。3.0 官方介绍
生成这样的图片,既要完整画出九个主题,也要给每个主题安排合适的版式,并让同一格里的文字与图形相互对应。
例如,几何格中的红色直线、绿色直线和平面各有含义,右侧条件、图中标签和底部结论要对应同一组对象。下方的银行流程则用编号表达次序。标签放错了位置,或编号打乱了顺序,即使每个字都清晰,含义也会改变。
读懂长指令后,模型还要安排布局、还原文字
把长说明变成画面,模型既要读懂对象之间的关系,也要在有限的像素中将它们画出来。公开的 2.0 技术报告解释了这一过程。
在那一代模型里,Qwen3-VL 将输入转为语义条件,扩散 Transformer 根据条件逐步生成压缩表示,图像编解码器再把它还原为像素。训练数据也区分了普通描述、密集文字描述和结构化描述;后者专门交代实体、属性与关系,帮助模型学习层级和连接方式。针对小字,团队还使用了文档和合成段落等文字密集图像训练编解码器。2.0 技术报告,第 2.2、3 节
这解释了为什么只增加提示词长度不够。说明中即使完整写下两条线与一个平面的关系,生成过程仍可能漏掉下标、把标签放在另一条线上,或在还原像素时让细笔画粘连。读懂关系、安排位置和画清细节,哪一步出错都会影响最终结果。
上述机制来自 2.0 报告。3.0 发布文章尚未披露完整训练方案,以下主要通过公开样例观察它的排版表现。
几何讲义将条件、图形与答案分区排列
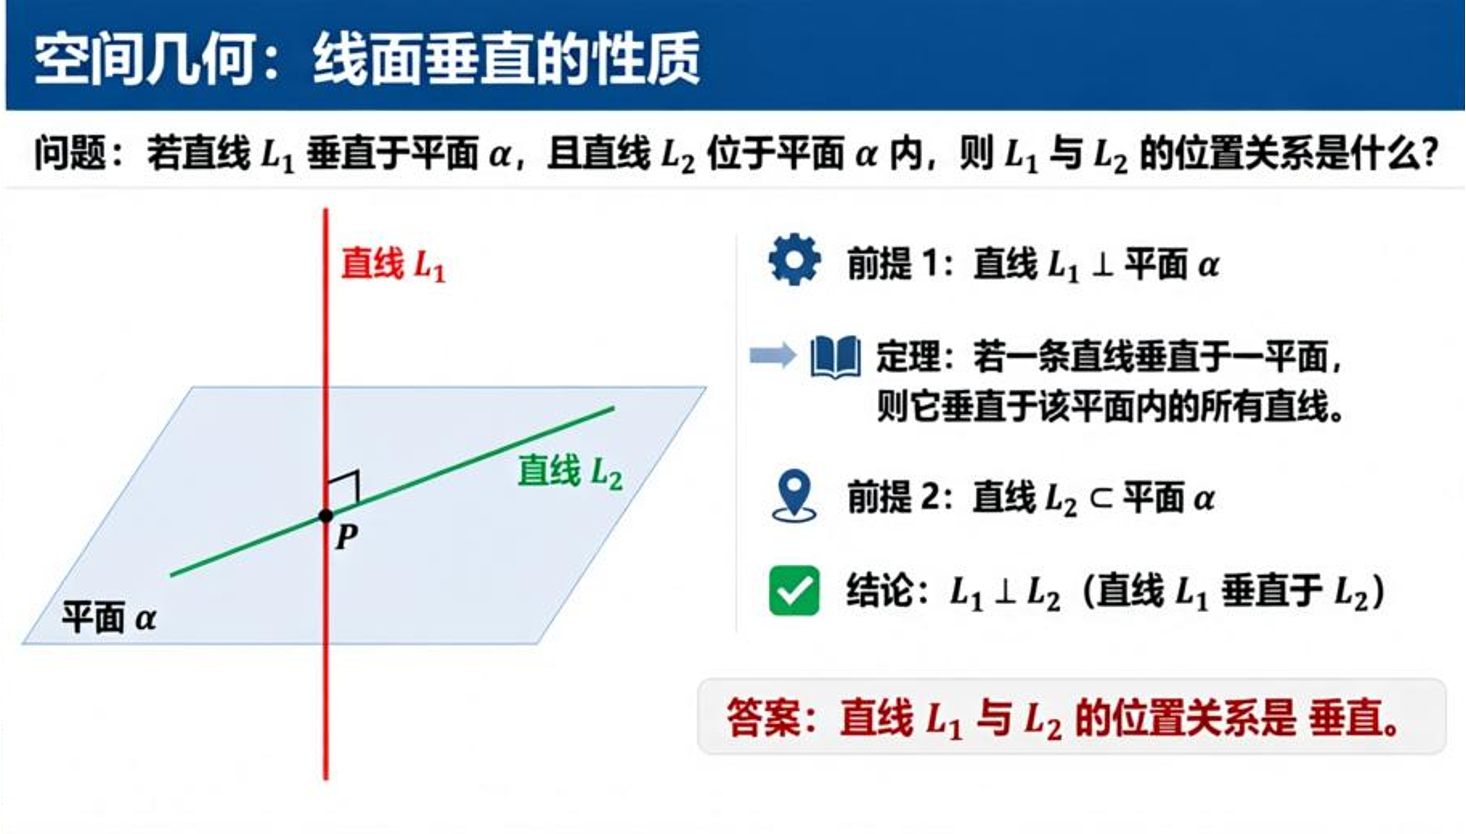
Qwen 官方单独展示的几何版面,对应九宫格上方中间一格。
这张图将问题放在标题下方,读者先看题,再对照左右两侧的图形和解释。两条线分别使用红色和绿色,图中标签也使用对应颜色;结论则放在独立的答案框中。主题、条件、图形和答案各有位置,阅读顺序比较清楚。
这样的样例展示了一种讲义初稿的做法:文案确定后,分别给出问题、推导、示意图和结论,让模型尝试一页中的布局,再由编辑核对内容和阅读次序。
四层嵌套界面,让海报出现在聊天和软件中
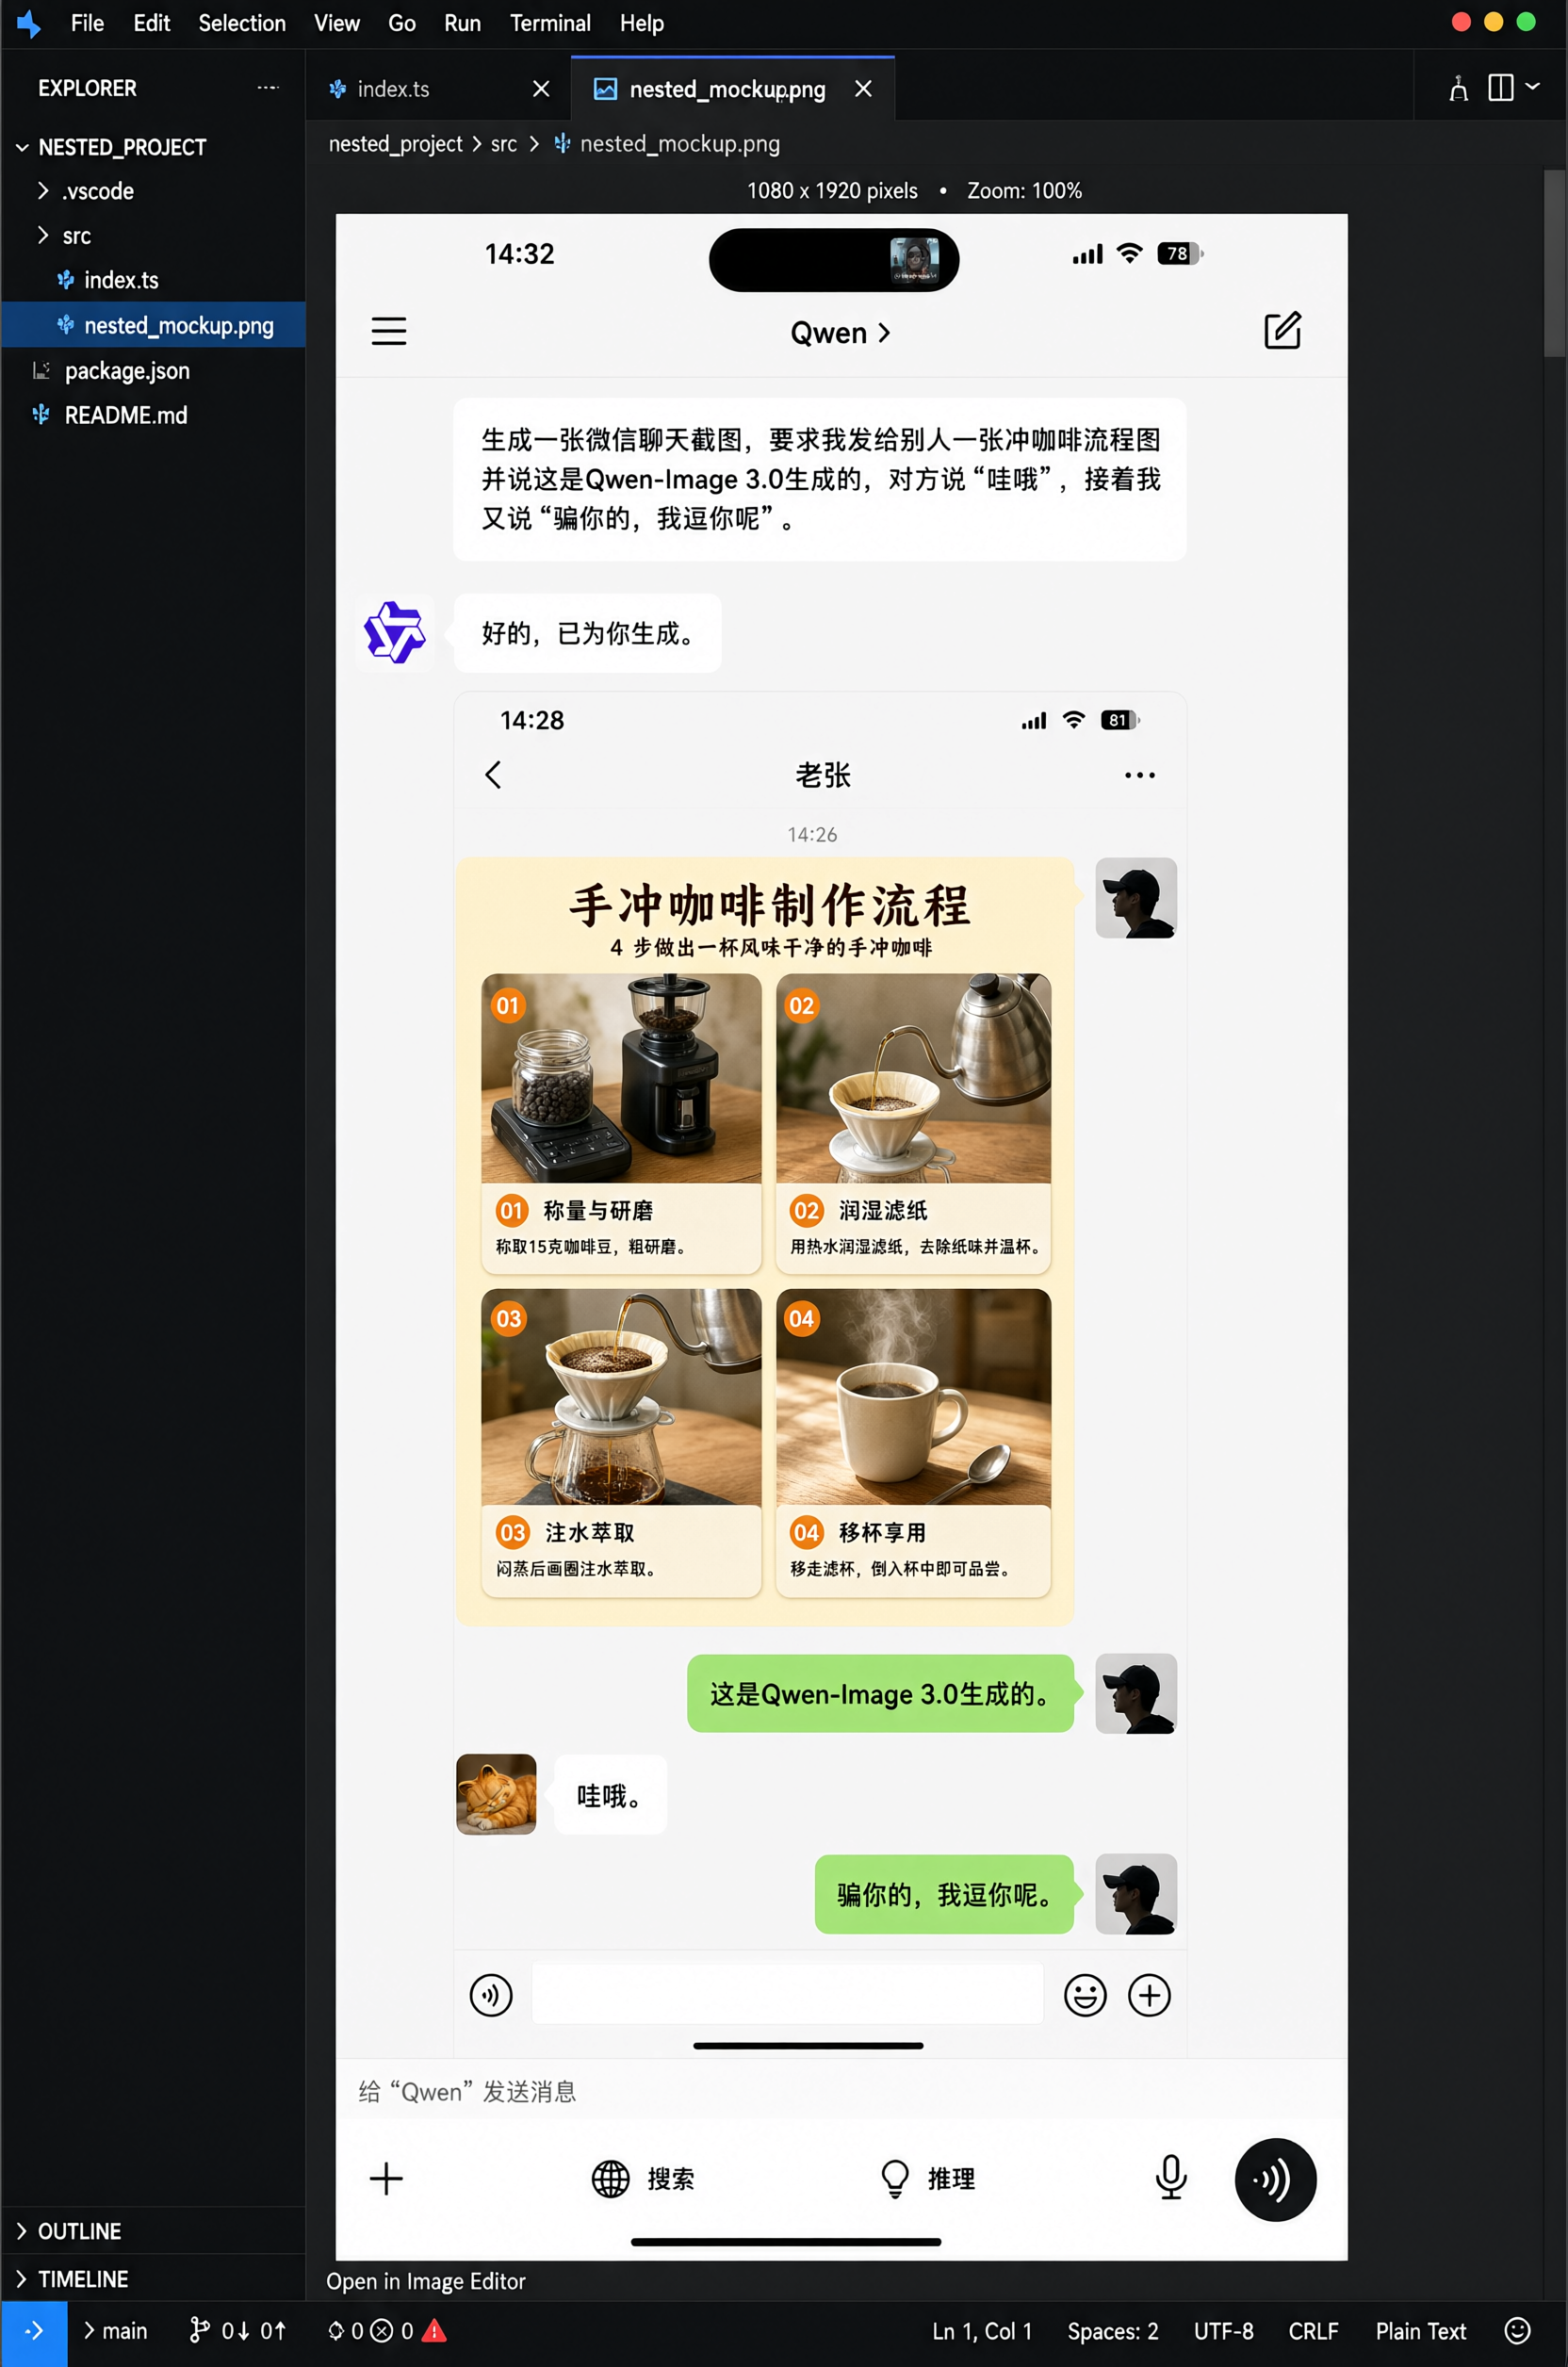
官方提供的四层嵌套样例。最外层是代码编辑器,向内依次是 Qwen、微信和咖啡流程图;这些都是生成图片中的内容。
九宫格将多个主题并列,这张样例则把内容逐层放入不同界面。代码编辑器中显示图片预览,预览里是 Qwen 对话,回复中又包含微信聊天,微信消息里再放入四步咖啡流程。
各层还有不同的界面元素:编辑器有标签页和状态栏,聊天有头像与气泡,流程图有编号与卡片。模型要区分它们各自所属的界面,避免把编辑器菜单画成海报标题,或把咖啡步骤放到微信对话外面。
在产品设计中,这类图片可以演示用户看到的具体场景。例如,把活动海报放入聊天转发界面,就能提前观察它在这一环境中的视觉效果。这些公开 PNG 适合沟通布局方案;若交付要求包括可编辑公式、幻灯片对象或可点击的界面,还需要在相应工具中制作这些对象。
图片缩到手机尺寸,小字可能难以辨认
官方同时宣称可渲染小至 10 像素的文字,并支持 12 种语言;公告未给出对应的系统字符错误率或语言分项测试。3.0 官方介绍
图片尺寸还会改变读者实际看到的结果。本文检查的九宫格原文件为 2720×1536 像素。假设其中某个字高 10 像素,当整张图片等比缩到 768 像素宽时,它的显示高度约为 10×768÷2720,即 2.8 像素。这只是缩放计算,未测量样例中每个字的字号,却足以说明:模型能在大图中排下的小字,未必适合整图缩小后直接阅读。
发布这种密集图片时,完整大图适合放大查看或审阅初稿,手机信息流则可能更适合将九个区域拆成多页。整图一次生成很方便,但继续缩小会让公式和数值难以辨认;拆成多页,可以给这些内容留出更大的显示空间。
文字看得清,也可能写得不准确。GIGAZINE 在 7 月 22 日发布的上手记录中,用 3.0 生成游戏界面和一张以拉面照片为基础的日文博客截图,报告了局部字符变形及日文表述不自然。这项体验只覆盖有限样例,无法代表各语言的平均错误率,却也显示:布局完整、远看逼真的图片,仍可能有需要逐字修正的内容。GIGAZINE 原始体验
这也影响了信息材料的制作过程:正文和数字确定后,再按区域交代版面关系;生成后对照原材料检查各区内容,尤其留意模型补充的解释。修改一处文字,还可能影响相邻区域的排版。
Qwen-Image 3.0 让一张生成图容纳更多主题、文字和图形。完整大图可以保留作审阅稿,手机端需要细读的区域则可以拆成多页。能否用于最终发布,取决于具体尺寸下的公式、标签和正文是否准确、清楚。