一台机械臂已经能靠规划器把玩具放上盘子、先挪开障碍再整理托盘,却几乎无法把这套动作教给一个预训练机器人模型。研究者给同一个 π0.5-DROID 检查点喂了 20 条成功的规划轨迹,三项桌面任务平均成功率只从 1.7% 升到 8.3%。问题不在轨迹有没有完成任务,而在它们的关节姿态、运动节奏和停顿方式不像模型过去见过的数据。
9 月 11 日提交的 DATAFARM 论文试图修正这层错位。它没有增加目标任务的人工示范,而是用 π0.5-DROID 预训练所用的 DROID 遥操作数据建立一套“动作分布参照”,再让规划器在满足碰撞、抓取和放置约束的同时,选出更接近这套参照的动作。经过对齐后,同样由规划器自动采集的 20 条示范把三项任务平均成功率推到 56.7%,接近人工遥操作示范的 61.7%。
这组实验给机器人数据生产提出了一个更严格的标准:示范“做对了”只是第一关,示范的行为分布还要让现有模型学得进去。
同一个终点,机械臂可以用完全不同的姿态到达
DATAFARM 建立在 TiPToP 上。TiPToP 把图像和语言指令转成三维场景、候选抓取与符号目标,再用任务与运动规划(TAMP)同时决定动作顺序、抓取位置、放置位置以及中间的无碰撞轨迹。它可以在没有目标任务训练数据的情况下解题,也正因为如此,天然适合作为自动示范生成器。
问题出在“可行解”远不止一种。机械臂末端到达同一抓取点时,七个关节可能形成多套姿态;连接两个姿态的路径可以更直或更绕,速度可以均匀,也可以在抓取前突然停住。传统规划器优先保证运动学可行、避障和平滑,并不关心哪种动作更像人通过遥操作采集的轨迹。
这种差异对行为克隆很重要。2024 年一项关于接触密集操作的独立研究已经发现,采样式规划器生成的高熵、不一致示范会拖累策略学习,研究者必须约束数据生成方式,才能让规划结果变成有效训练材料。DATAFARM 把这个问题推进到预训练 VLA:即使规划轨迹本身稳定且全部成功,它仍可能偏离基础模型已经形成的动作先验。
三层对齐分别约束姿态、路径和执行节奏
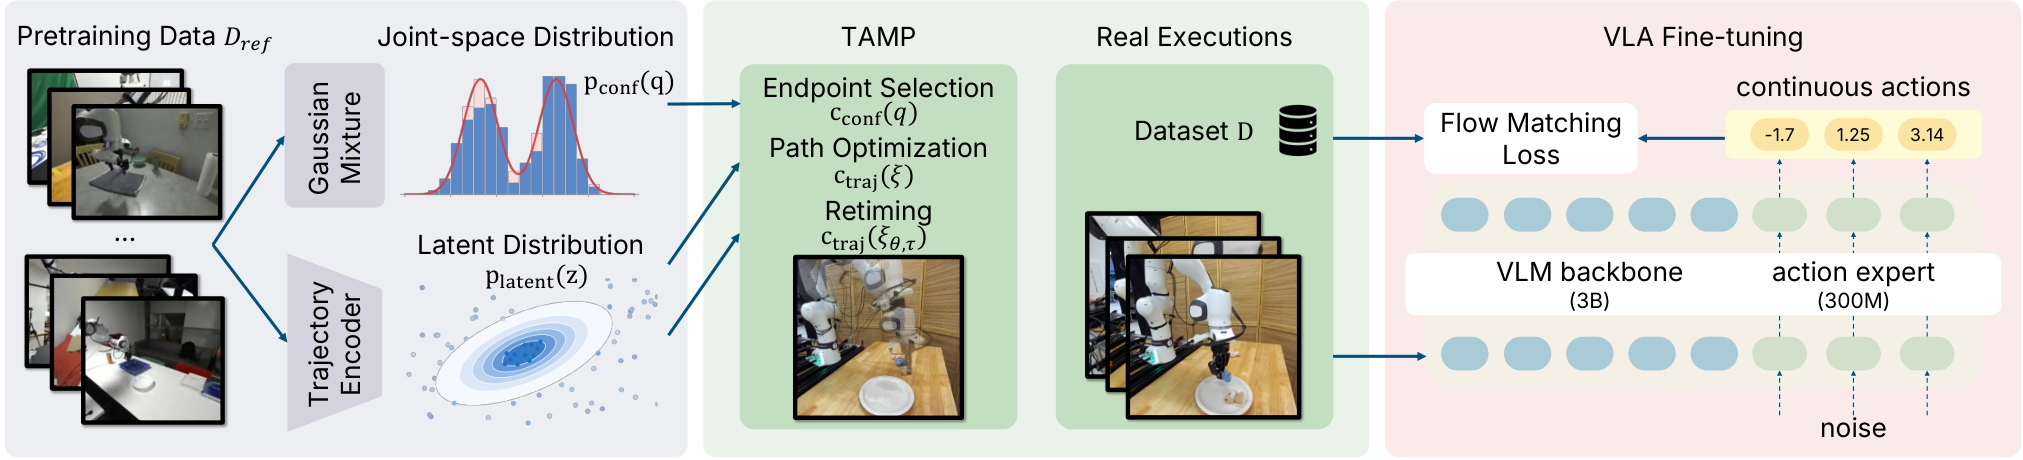
DATAFARM 没有要求参考数据包含目标任务。它从 DROID 中抽取 4,000 条预训练示范,用其中 987,631 个运动帧拟合七个关节姿态的高斯混合分布;这个分布只回答“预训练数据里常见什么姿态”,具体姿态能否完成抓取和放置仍由规划器判断。
第二层处理整段运动风格。研究者训练一个轨迹编码器,把关节位置、速度、加速度和加加速度压缩成 16 维表示。训练目标覆盖速度波动、路径长度、方向反转、频谱和运动平滑度等 113 项描述。规划时,候选路径距离 DROID 表示分布越远,代价越高;梯度再反向推动规划器修改中间路点。
第三层单独调整时间。系统保持几何路径不变,改变每一段的持续时间和沿路径推进的速度,并在抓取事件附近约束边界速度。这样做的原因是,形状相同的轨迹只要执行快慢和停顿位置不同,对以固定频率接收动作的 VLA 就是不同训练样本。
三层约束并没有取代任务规则。碰撞检测、关节速度和加速度上限、抓取与放置条件仍然由 TiPToP 检查;分布对齐是在可行解之间重新排序,而不是让模型用“像人”交换“做对”。
56.7% 来自 60 次评估,不是通用机器人结论
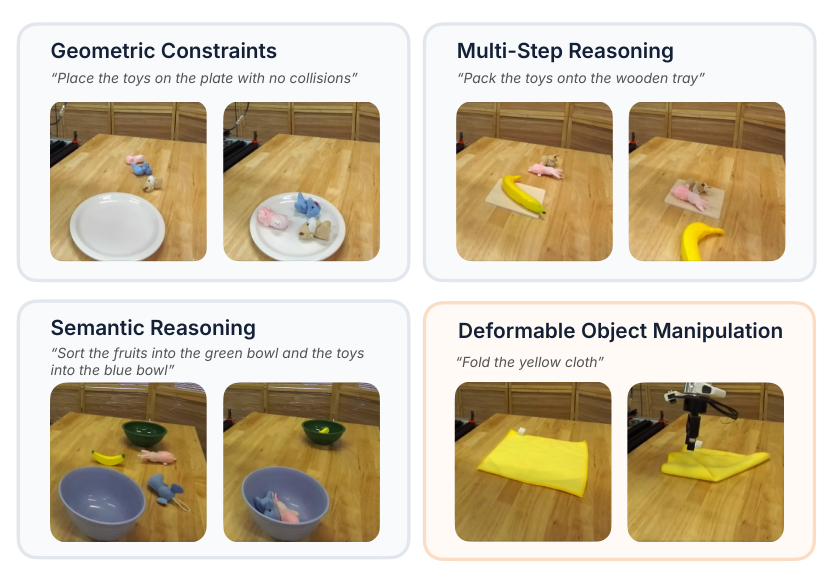
实验使用一套 Franka Panda 七自由度机械臂和 π0.5-DROID,目标是三个各含三次物体移动的桌面任务:在有限空间里把三个玩具放上盘子;先移走托盘上的障碍,再放入两个玩具;按语义把三个物体分到两个碗里。每个数据来源、每个任务都单独用 20 条成功示范微调一个检查点,再在 20 个新初始场景上评估一次。
未做目标任务微调的模型在三项任务中分别成功 0%、0% 和 5%,平均 1.7%;使用原始 TiPToP 轨迹后是 5%、5% 和 15%,平均 8.3%;DATAFARM 对应为 65%、35% 和 70%,平均 56.7%。人工遥操作示范得到 50%、45% 和 90%,平均 61.7%。所谓“接近人工示范”,因此指同一组有限任务、同样每项 20 条示范和 20 次测试下的算术平均,不是对所有机器人任务的替代证明。
消融实验让机制更清楚。去掉关节姿态对齐,平均成功率降到 23.3%;去掉运动风格对齐,降到 15%;去掉时间对齐,三项任务 60 次测试全部失败。DATAFARM 轨迹在二维投影里与 DROID 轨迹表示的重叠率达到 96%,但去掉风格对齐后仍有 89% 重叠,成功率却只有 15%。这说明图上的分布接近只能用于诊断,不能代替真实任务评估。
论文还把“成功率”和“任务进度”分开。一次测试必须完成七个预设子目标才算成功;任务进度则允许部分完成。DATAFARM 的平均成功率为 56.7%,平均进度为 84.7%。在几何约束任务上,示范从 20 条增至 40 条时成功率从 65% 升到 75%,60 条仍为 75%,到 80 条才升至 85%。至少在这项实验里,增加轨迹数量并没有线性换来成功率。
这套方法依赖看得到的预训练分布
目标任务微调还可能让模型忘掉原有能力。作者因此选了规划器不会做的布料折叠作为保留能力检查:原始 π0.5-DROID 在 20 次测试中成功 90%;分别用三个目标任务的 DATAFARM 数据微调后,成功率为 80%、85% 和 90%,平均 85%。这组结果说明该设置下没有发生严重遗忘,但一项布料任务不足以代表整个预训练能力面。
更现实的门槛是参考数据。DROID 含 76,000 条遥操作轨迹、约 350 小时交互,覆盖 564 个场景和 86 类任务;π0.5-DROID 正是在这套数据上适配,因此研究者既知道模型见过什么,也能直接抽样建立姿态与轨迹分布。对于不公开预训练数据的 VLA,使用者只能寻找替代数据集,而替代分布是否足够接近模型真正见过的数据,论文没有给出答案。
实验范围也很窄:一个检查点、一种机械臂、三项准静态抓放任务和一项能力保留测试。DATAFARM 继承了底层规划器的边界,尚不能生成接触密集、推拉或非抓取操作的示范;每个结果又只来自一个训练检查点和 20 次评估,没有跨随机种子、跨实验室或跨 VLA 验证。
因此,这项工作的增量不是证明合成轨迹可以普遍替代人工遥操作,而是把机器人数据的验收条件从“规划器完成了任务”推进到“轨迹是否与基础模型的行为先验相容”。接下来真正决定它能否成为通用数据管线的,是同一套三层对齐在不同 VLA、不同本体和接触密集任务上,能否继续比单纯增加示范数量更有效。