Thinking Machines Lab 11 月 20 日放出 Inkling 2 Mini 的开放权重。这是一个总参数 26.4B 的混合专家模型,按 Apache 2.0 许可发布,原生检查点大约 20GB。官方模型卡写明,它可以在内存不低于 32GB 的 Apple 芯片设备,或一张 NVIDIA DGX Spark 上本地运行。
做法是把 24 层里中间的 12 层对每个 token 循环跑三遍,公司把这种结构叫循环 Transformer。独立评测机构 Artificial Analysis 同日给出的 Intelligence Index 是 20,与 Qwen3.8 27B 的 xhigh 档打平,但有效激活参数更少。
中间 12 层对每个 token 跑三遍
据模型卡,Inkling 2 Mini 是 24 层解码器,前馈层用稀疏混合专家:每一层把 token 路由到 128 个专家里的 8 个。注意力是局部层和全局层的混合,图像由视觉 Transformer 编码后与文本进入同一隐空间。它接收文本和图像,输出文本,上下文窗口最长 100 万 token。
参数要分两个口径。不含循环时,激活参数是 3.4B;中间层循环三次后,每个 token 的有效激活大约是 5.4B,因为每多跑一遍,大约再增加 1.0B。权重本身仍是 26.4B,并没有变成更大的模型。
官方博客说,24 层分成四组、每组 6 层,中间两组跑三遍,首尾两组各跑一遍。公司给出的理由是:中间层更承担抽象推理,首尾层更多负责嵌入和内部表示之间的转换。它在实验里写,循环中间 12 层,在 28 项评测中的 27 项上,比循环最后 12 层带来的准确率提升更大。层与层之间还用了注意力残差,用来在不同循环之间传递信息,这项设计引自 Kimi 团队 2026 年的工作。这些机制描述来自公司,本轮没有独立复现。
循环提高的是推理时可以花在同一个 token 上的计算,模型能记住的事实并不随循环增加。官方表格里,Inkling 2 Mini 在事实性指标 AA-Omniscience v1.1 上得分为 -8.6,低于同表中的 Qwen3.8-27B(-6.4)和 Nemotron 3.5 Super VL(-2.9)。公司说,在可变循环的研究模型上,加循环次数能提高 GraphWalks、MRCR 这类长上下文评测,但 AA-Omniscience、SimpleQA Verified 等知识类评测没有随之上升。
独立榜单和公司表格并不完全同向
Artificial Analysis 11 月 20 日的评测文章写,Inkling 2 Mini 的 Intelligence Index 为 20,与 Qwen3.8 27B(xhigh)以及 Nanbeige4.3-33B 持平,而有效激活参数大约分别只有后两者的 1/5 和 1/6。按该机构的计算,它完成同一套指数任务的成本是 0.59 美元、耗时 9.0 分钟,Qwen3.8 27B 是 3.53 美元、38.2 分钟。成本用的是 Thinking Machines 的官方价:输入每百万 token 0.15 美元,输出 0.50 美元,缓存命中 0.015 美元。
同一篇文章也写了限制。Inkling 2 Mini 每个指数任务平均输出约 15.2 万 token,比 Qwen3.8 27B 的约 11.0 万多大约 38%。按“激活参数乘以 token 数”的计算代理,它用的计算量约为后者的 1/2.8。它也被标成非常啰嗦:整套 Intelligence Index 产出 1.61 亿输出 token,对比同类中位数 8570 万。智力分数也没有超过所有模型,该机构写明 GPT-6 Luna 的 max 档是 28 分,单任务成本 0.15 美元。
公司自己的对照表口径是“总参数小于 100B 的开源模型”。在这张表里,Inkling 2 Mini 的 DeepSWE v1.1 为 48.2%,SWE-bench Pro v2 Hard 为 77.9%,Vals Index v2.2 为 46.5%,公司称这些是该组里最高的。同一张表里,它并不是项项第一:Terminal Bench v2.1 是 71.6%,低于 Qwen3.8-27B 的 73.0%;AutomationBench-AA 是 41.8%,低于 Qwen 的 48.2%;AA-Briefcase 和 GDPVal-AA 也落后于 Qwen。官方在图注里写明,各模型的评测设置并不统一。公司表上的 AA Index 写作 20.1,与 Artificial Analysis 公布的 20 是同一指数的四舍五入差异,不是两组不同结果。
官方也承认短板:它不是最强的小模型去做多轮对话或约束很多的指令,MultiChallenge 为 50.0%,ComplexConstraints v1.1 为 33.4%,两项都落后于 Qwen3.8-27B;在 CritPt v2、HLE-Diamond 这类更吃推理的评测上,它也落后于更大的模型。
能在笔记本上跑,演示机器比最低档更宽裕
原生权重量化为混合的 NVFP4 和 MXFP8,最后四层用 MXFP8,整包大约 20GB。模型卡建议的本地硬件是:一张 NVIDIA DGX Spark;内存 32GB 及以上的 Apple 芯片电脑;其他平台建议有 32GB 及以上显存。量化后的 GGUF 可通过 Unsloth 和 llama.cpp 使用,推理框架还包括 SGLang、vLLM、Ollama 等。权重在 Hugging Face 可下,也在公司的微调平台 Tinker 上提供推理和定制。
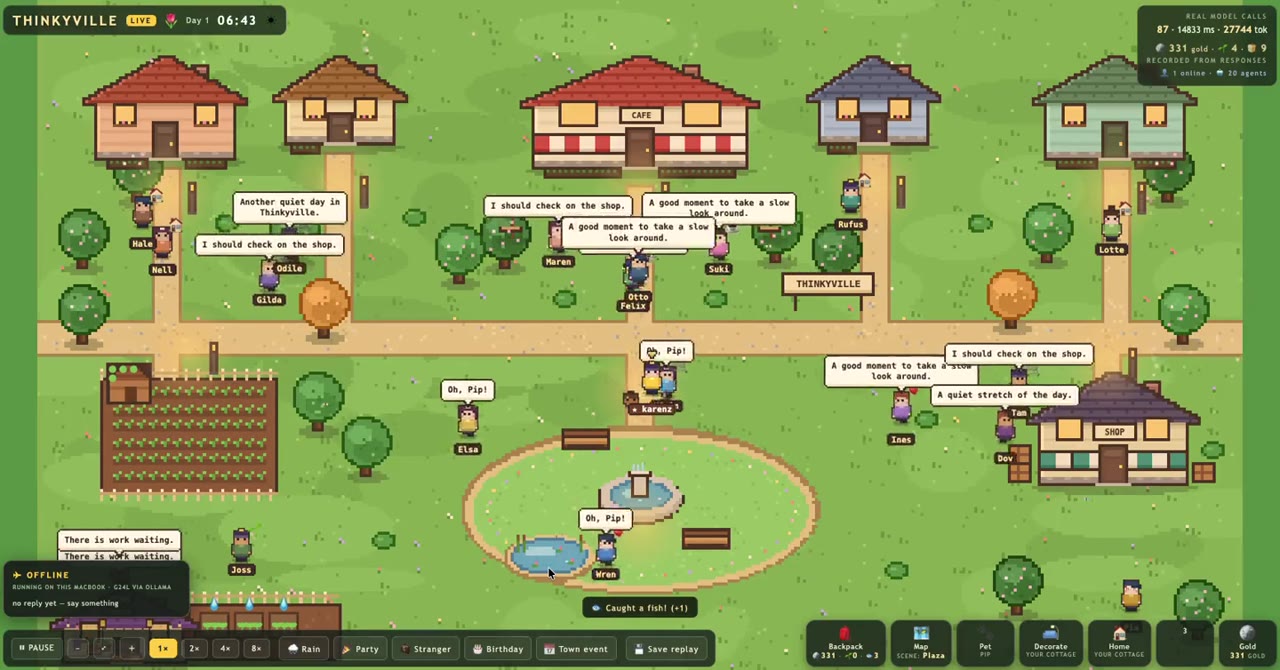
公司在博客里放了两段离线演示:研究人员带着这款模型坐飞机,在 MacBook Pro 上做出一个可玩的飞行模拟器;另一个演示是名为 Thinkyville 的像素小镇,20 个村民由同一模型驱动。这两段视频用的机器是 48GB 内存的 MacBook Pro(M5 Pro),并开了飞行模式。演示说明它可以在无网络的笔记本上工作,但不能把它当成对 32GB 最低配置的第三方性能测试。
公司还同时放出一个可变循环次数的研究模型,用来观察循环深度对推理和可监控性的影响。按官方实验,这个研究模型在不写思维链时的时间跨度,从循环 1 次的 16 秒提高到循环 3 次的 37 秒;在一项串行推理评测上,循环加到 10 次仍有提升,是训练时循环次数的两倍。思维链会随循环变短,但公司称可读性没有下降,在智能体破坏类测试上也没有随循环升高。这些结果同样来自公司,且部分实验用的是研究变体,不是对外发布的默认模型。
对本地部署的人来说,现在可以核对的是许可、体积和官方硬件门槛,以及 Artificial Analysis 已经跑完的那组指数。循环能不能在知识任务和多轮对话里也省下同样多的参数,还要看权重公开之后更长时间的第三方测试。
