SWE-bench Verified 的榜首曾出现一个罕见场面:前两份提交都解出 500 道题中的 396 道,第三名只少两道。排行榜仍能把它们排成第一、第二、第三,但一项对逐题结果的审计发现,名次比数据本身更精细——前 30 名的 29 组相邻提交,没有一组通过配对显著性检验。
9 月 15 日发布的论文汇总了 SWE-bench 四个公开 split 的 254 份提交,并冻结在 7 月 30 日可获得的数据。它没有重新运行任何模型,而是利用官方已经公开的逐题 verdict,追问一个比总分更窄也更实际的问题:当两个系统都在同一批 GitHub issue 上接受同一套判定时,零点几分的差距究竟够不够支持“前者更强”?
答案不是“这些 Agent 能力相同”。更准确的说法是:在这份快照里,SWE-bench Verified 可以记录各系统解了多少题,却没有为头部相邻名次提供足够的统计分辨率。对用排行榜筛选供应商、模型和 Agent 方案的团队来说,名次适合做初筛,不适合直接充当采购结论。
500 道题中,只有 164 道还能区分前十名
总分把每道题都计入分母,不论它是否真的帮助比较。论文把“所有待比较系统都解对”或“全部失败”的题称为退化题:它们能描述整体通过率,却不能区分这组系统。
在 Verified 前十名中,285 道题被十个系统全部解对,51 道题被全部做错,只剩 164 道出现分歧。也就是说,500 道题里只有 32.8% 对前十名之间的比较提供信息。范围收窄到前两名后,378 道共同成功、86 道共同失败,真正有分歧的只剩 36 道;两者各解出 396 道,但在这 36 道上各有 18 道独占成功。
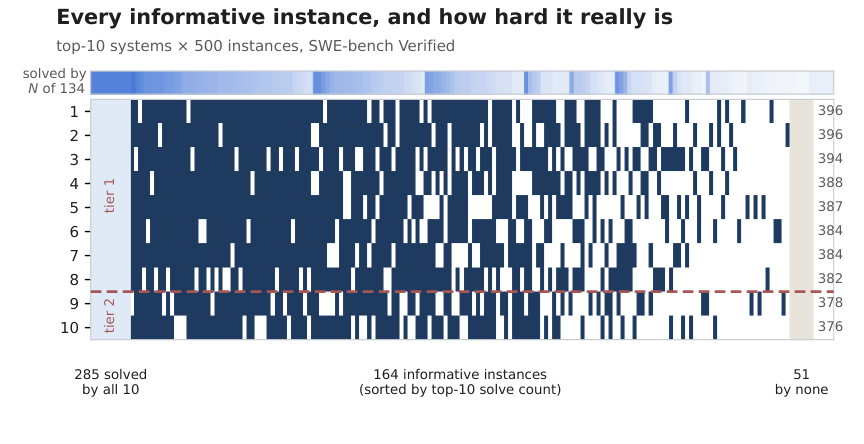
这不是简单的“题目太少”。头部系统解对的题高度重叠:论文计算的前沿系统成功集合中位嵌套度为 0.935,高于由分数本身推得的 0.774 基线。换句话说,较弱系统解出的题,大多也被较强系统解出;新增加的共同成功题会抬高总题量,却不一定制造新的比较信息。
复算公开工件还能看到这种互补性的边界。单个最佳提交解出 396 道,前十名成功集合的并集覆盖 449 道,多出 53 道。这个“并集”需要事后知道每道题该选谁,并不等于一个可部署的组合系统,但它说明榜单隐藏了两类不同信息:总体通过数,以及系统之间在哪些题上真正不同。
McNemar 检验只看双方分歧,29 组相邻名次全部未分开
同一批题上的两个系统不是两组独立样本。每道题会落入四种情况:都成功、都失败、只有 A 成功、只有 B 成功。精确 McNemar 检验只比较后两种分歧是否明显偏向一方,因此比直接拿两个总分相减更贴合排行榜数据结构。
前两名同为 396/500,在 36 道分歧题上恰好打成 18 比 18。第二名与第三名相差两道,但 66 道分歧题只形成 34 比 32。论文对前 30 名依次做了 29 次相邻比较,在 0.05 显著性水平下没有一组被分开;相邻差距的中位数只有 1 道题,所有相邻比较中最小的原始 p 值仍为 0.545。
作者随后用一条预先说明的规则把前 30 名合并为描述性层级:不做多重比较校正时得到 3 档,分别包含 8、12 和 10 个系统;应用 Holm 校正后只剩 2 档,分别为 19 和 11 个系统。这些层级不是“能力相等组”,因为未拒绝差异不等于证明等价,检验也没有预设业务上可接受的等价区间。它们表达的是更有限的结论:现有逐题证据最多支持这样粗的分组,支撑不了 30 个严格次序。
同一方法在更有分辨率的地方会给出不同结果。包含 2294 道题的 Test split 中,24 份提交的头部成绩跨度更大,23 组相邻比较有 14 组能够分开。这个反例表明,McNemar 检验并非注定对排行榜说“不显著”;Verified 的问题来自头部系统收敛、成功集合嵌套和有效分歧题不足的组合。
排行榜的一行成绩,实际对应模型与 scaffold 的组合
统计分辨率之外,榜单还混合了比较对象。一次提交的结果来自模型和 scaffold 的共同作用:后者包括 Agent 循环、工具、检索、上下文管理与控制策略。开放排行榜展示系统名和总分,却没有把两者稳定拆开。
论文只能从元数据中重建 61 份具有单一可用模型标签的 Verified 提交,占 134 份快照的 46%;标签还存在同一模型多种写法,scaffold 名称则要从提交目录推断。在至少搭配两种 scaffold 的模型中,同模型成绩范围的中位数为 15.6 个百分点。Claude 3.5 Sonnet 的九种 scaffold 横跨 29.8 个百分点,而整个前 30 名仅相差 8.8 个百分点。
这组观察不能证明 scaffold 单独“贡献”了多少分。提交来自不同团队和日期,提示词、工具、预算与共同调优都可能混在其中;同一模型与 scaffold 的重复提交本身也会漂移。它证明的是另一件事:如果榜单没有记录可核对的模型、scaffold、版本和运行条件,读者就无法把一行系统成绩还原成模型能力排名。
SWE-bench 官方已经提供一种更窄的比较方式:用统一的 mini-SWE-agent 和 bash 环境评估不同模型,并把它与允许任意 Agent 的完整榜单分开。官方同时提醒,mini-SWE-agent 1.x 与 2.x 因工具调用方式变化并不天然可比。固定 scaffold 能减少一个主要混杂因素,却仍不能替代逐题比较、重复运行和版本记录。
任务质量、数据污染和排名分辨率是三道不同的检查
这项研究没有证明 500 道题本身都可靠。此前研究发现,模型只读 issue 描述、不看仓库结构,也能在 Verified 上以最高 76% 的准确率定位出错文件;在 SWE-bench 之外的仓库上最高为 53%,提示记忆或数据污染可能影响成绩。OpenAI 对另一套 SWE-Bench Pro 的审计又发现约 30% 的公开任务存在严格测试、描述不足或覆盖不足等问题。
这些工作检查的是任务是否有效、是否受污染;本论文检查的是即使接受现有 verdict,名次能否被逐题结果支持。三道门槛不能互相替代:清理坏题不会自动让相邻系统可区分,增加题量也不会自动消除污染,而显著差异更不等于评测覆盖了真实生产需求。
本论文还有清楚的边界。它是公开提交的观察性二次分析,没有重跑模型;每份提交通常只有一次结果,因此配对检验重采样的是题目,没有纳入运行波动。榜单会继续更新,结论对应的是冻结快照。作者也没有定义“业务上多大差距才值得换系统”,所以统计层级不能替企业完成成本、延迟、安全和维护性的权衡。
采购时先找分歧题,再决定要不要相信名次
对采购和技术选型团队,最直接的改法不是寻找另一个更长的单一排行榜,而是把比较对象和决策任务对齐。
如果目的是选模型,应固定 Agent 框架、工具、预算和版本,并做多次运行;如果目的是选完整产品,则应把模型与 scaffold 视为一个整体,不再用总分归因模型。两种情况下都应保留逐题结果,优先检查候选系统在哪些任务上分歧、这些任务是否接近自己的代码库,以及差异是否稳定偏向同一方。
对榜单维护者,最低限度的发布单元也应从“系统名 + 总分”扩展为模型版本、scaffold 与 harness 版本、运行设置、逐题 verdict 和重复次数。排名旁边应报告相邻配对检验或可区分层级,并说明结果对多重比较校正有多敏感。
500 道题并没有突然失去价值。它们仍能告诉读者一个系统解决了多少公开 issue,也能区分跨度足够大的系统。真正需要放弃的是另一种习惯:看到 79.2%、78.8% 和 77.6%,就把小数点后的差距当成已经证实的第一、第二和第三。下一代榜单最需要增加的不是名次精度,而是能让候选系统产生稳定、方向明确分歧的题,以及完整到足以解释这些分歧的运行记录。