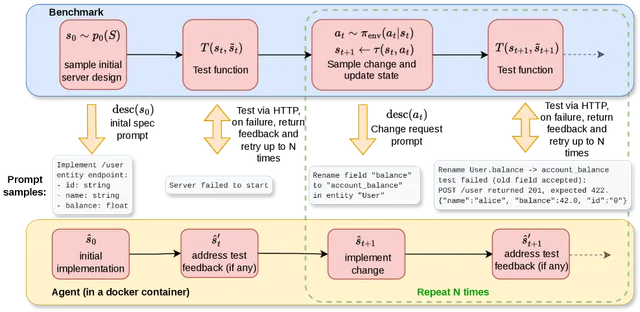
如何衡量代码 Agent 在多轮协作中的表现,正成为评测研究的新问题。6 月 29 日,Meta 团队在 arXiv 上发布了 SWE-Together——一个从 11,260 次真实用户-Agent 编程会话中重建的多轮交互基准。它同时考察最终代码的完成情况和协作过程:Agent 需要模拟用户提供多少纠正与提醒,才能完成任务?
这一研究也回应了静态基准的局限。随着 SWE-bench Verified 上 Claude Mythos 5 达到 95.5%、Opus 4.8 达到 88.6%,传统静态基准正逼近天花板,越来越难以区分前沿模型之间的实质性差异。OpenAI 也已停止报告 SWE-bench Verified 成绩,理由是剩余任务中大量测试用例拒绝功能正确的方案或要求未明确规定的行为。测试质量与交互方式因此都需要重新审视。
从 11,260 次会话中筛出 109 个可复现任务
SWE-Together 的任务并非人工编写,而是来自四个上游开源数据集的真实会话:DataClaw、Pi-staging、Hyperswitch 和 SWE-chat。Meta 团队设计了一条三阶段流水线,将原始会话转化为可复现的沙箱任务。
第一阶段是确定性规则过滤:会话必须包含多轮真实用户消息、Agent 的实际代码编辑行为,且涉及的仓库为公开的、足够成熟的项目。最终补丁主要由人类用户编写的会话被排除——确保每个入选任务中 Agent 完成了实质性的编码工作。
第二阶段由 LLM 进行可行性筛选:判断会话的核心编码目标是否可以在本地环境中重构,排除依赖外部状态(PR 管理、部署操作、私有凭证)的任务。
第三阶段在隔离沙箱中完成最终构建:克隆仓库到固定 commit、识别测试命令、生成用户模拟提示词。最终 11,260 个会话中只有 109 个通过全部筛选,转化率仅为 0.97%。这一通过率说明,在这些筛选条件下,只有少量原始会话能被还原为可复现的评测任务。
模拟用户根据 Agent 进展决定何时介入
SWE-Together 还需要解决如何向不同 Agent 重放同一任务的问题。传统的多轮评测要么固定推进用户消息(时机可能与新 Agent 的轨迹不匹配),要么使用通用角色扮演(容易偏离原始任务意图)。
Meta 的方案是一个以原始会话为依据、根据当前状态反馈的 LLM 用户模拟器。每次重放时,模拟器在每个 Agent 回合结束后汇总实时轨迹,做出一次结构化决策:发送消息或保持沉默。它的动作空间包括五个选项——no-op(默认)、question(澄清)、redirect(纠偏)、new-requirement(新增需求)、check-external(要求检查外部产物)。
模拟器不按固定时间表发送消息,只有在 Agent 轨迹触发特定条件时才会介入,时机和内容都根植于原始会话的分析结果。这意味着不同 Agent 可能收到不同数量和不同时机的反馈,设计目标是让反馈保留原始用户的意图和任务范围。
论文用 Intent Coverage 检查这一设计的稳定性。该指标综合衡量意图传达的完整性与是否超出原始范围,给意图召回率和范围精确率分别赋予 70% 和 30% 的权重。实验显示,七款模型中有六款的 Intent Coverage 在 0.70 到 0.72 之间,差异极小,说明模拟器行为跨模型稳定。
研究还安排了图灵测试:四位人工标注者在 312 次二选一判断中无法可靠区分模拟用户和真实用户——模拟器的图灵通过率为 46%(95% CI 包含 50%),在这项测试中未发现可靠的区分能力。
七款受测模型中,得分较高者通常需要更少纠偏
论文使用统一的 opencode harness 评测了七款前沿模型,每任务运行 2 次副本(k=2)。评分不依赖简单的测试通过/失败,而是使用一个冻结的双阶段 Agent 评判器:第一阶段为每个任务生成加权完整性目标,第二阶段对所有候选方案应用相同的 rubric。成功阈值设为 judge score ≥ 0.85。
主要发现如下:
Claude Opus 4.8 四项正确性指标最高:pass@1 63%、SSR 59%、pass² 52%、MeanJudge 0.801,四项正确性指标均为最高。同时 User Correction 仅为 1.38,是七款模型中最低的——这是显式纠正按 1、较轻提醒按 0.2 加权后的平均值,并非只统计显式纠正的次数。
GPT-5.5 的用量和耗时最低:以 MeanJudge 0.763 排名第二,每任务平均消耗 29,900 个输出与推理 token,耗时 10.7 分钟,两项均为本次受测模型中最低。Opus 4.8 得分最高,但相同口径的 token 消耗为 74,000,是 GPT-5.5 的 2.5 倍。
GLM-5.2 两次运行均成功的任务比例更高:GLM-5.2 与 GLM-5.1 的 SSR 分别为 48% 和 49%,但 GLM-5.2 的 pass² 为 42%,高于 GLM-5.1 的 35%。后一个指标要求同一任务的两次运行都成功。
MiniMax-2.7 正确性得分最低、纠偏最多:四项正确性指标均为最低,User Correction 最高(2.17)。
在这七款模型的结果中,正确性与加权纠偏次数呈较强负相关。User Correction 与 pass@1 的 Pearson 相关系数为 -0.92,与 SSR 为 -0.84,与 MeanJudge 为 -0.93。这种关系在仅统计「收到至少一次纠正」的任务子集和「困难任务」(MeanJudge < 0.85)子集上同样成立。也就是说,得分较高的模型通常更常完成任务,并需要更少的纠正和提醒。这为研究开发者的协作负担提供了一个指标。
参考补丁通过率约 78%,用于比较而非设定上限
作为对照,研究者从 109 个任务中提取出了 93 份可用的参考补丁,即原始会话中人类-Agent 协作的实际代码结果。其中 73 份通过评判,pass 率约为 78%,MeanJudge 为 0.90。这个通过率比 Opus 4.8 的 pass@1 高约 15 个百分点,但参考补丁覆盖的任务子集不同,不能直接视为同一任务集合上的差距。
论文分析了参考基线未达到 100% 的三个原因:约 35% 未满足的目标是「过程性需求」(如先诊断根因再修改、回答后续问题),这些是最终代码补丁无法体现的;少量参考补丁不完全捕获跨多 commit 或跨会话的工作;还有极小部分确实是原始会话中的不完美解决方案。同一冻结 rubric 适用于参考补丁和所有 Agent,因此参考行应被视为「同等评分标准下的参考点」而非可解决性上限。
纠偏指标补充结果评分,但不能代替真实用户研究
近期其他工作也在讨论编程评测的局限,包括 OpenAI 退出 SWE-bench Verified 报告、DeepSWE 记录 SWE-bench Pro 中验证器可靠性问题、以及业界对「Agent 不应仅按最终代码正确性评估」的共识增长。
Meta 的贡献在于提供了一个系统性的替代方案:不依赖固定的 test suite、不要求 Agent 模仿参考实现的路径、将评测从「结果导向」拓宽为「过程加结果」。User Correction 这一指标尤其值得关注——它提供了 pass@1 之外的协作负担指标。不过,加权纠偏次数并不直接等于开发者花费的时间,还需要真实使用中的测量。
但 SWE-Together 也有明确的边界:模拟器不能中断 Agent 运行中的回合、不能直接编辑文件、依赖纯文本轨迹而非界面视觉信息。它最适合目标清晰、结果可衡量的任务,对模糊开放式任务和难以量化的用户行为覆盖有限。109 个任务的规模也意味着统计显著性需要审慎解读。
即使得分最高的 Opus 4.8,也仍会收到模拟用户的纠正与提醒。后续需要观察,这些指标与真实开发者的工作负担有多大关联,以及在更大、更多样的任务集上能否保持相同的模型差异。