9 月 6 日,OpenAI 宣布已经达到其去年设定的“自动研究实习生”目标:系统能在人类指导下完成边界明确的研究任务,包括原本需要熟练研究员数天的工作。这一判断依据的是 OpenAI 研究组织内部的 Codex 使用、代码提交、实验运行和任务结果数据。
研究员已经开始同时安排多个 AI 智能体(Agent)执行任务。报告中最醒目的指标是“每个人类工作日对应 3.1 个 Agent 工作日”,但它统计的是 AI 累计运行时间,不能直接换算成 3.1 倍生产率,也不足以证明 AI 已能通过改进自身加速研究。
3.1 个 AI 工作日是怎样算出来的
OpenAI 的计算方式很直接:汇总符合条件的 Agent 运行时,再除以 8 小时,得到“Agent 工作日”;人类一侧则把研究组织每名成员的每个日历工作日统一记为 8 小时。该指标采用截至 8 月 15 日的 28 天移动平均,超过 30 分钟的会话间隔会被视为非活跃时间剔除。
子 Agent 和自动代码审查线程也会单独计时,因此一个研究员同时启动多个 Agent,累计运行时间就会快速增加。相反,程序化自动化、codex exec、记忆整理、标题生成和内部评测流量等没有被纳入。它可以衡量组织投入了多少 Agent 运行时间,但不能回答这些时间创造了多少有效研究结果,也不能与员工真实记录的工时直接比较。
报告中的成本数字也需要区分标价与实际支出。OpenAI 称,到 8 月中旬,研究组织成员的每日推理用量按 API 标价折算,中位数超过 600 美元,90 分位超过 7000 美元。内部和预发布模型被映射到最接近的生产模型,并按 9 月 3 日零售 API 价格换算;这不是员工账单,也不是 OpenAI 披露的实际边际成本。
代码和实验增加了,研究进展还要看结果
相比运行时,代码与实验数据离研究活动更近。OpenAI 的图表显示,2026 年第三季度截至 8 月 15 日,每名活跃贡献者每天变更的代码行数达到 2025 年以前平均水平的 7.02 倍;每名活跃实验者的实验数在 8 月达到 2025 年基线的 1.60 倍。
代码和实验数量增加,并不直接代表研究速度提高。代码指标统计增删行并对单次提交做极值截断,贡献者按过去 365 天活跃的身份计算,并不等同于经过核验的人员数;实验指标排除了自动运行,并把每个负责人每天计入的实验数封顶为 100。OpenAI 自己也明确指出,实验增长与 Codex 采用相关,但同期可用算力同样显著增加,分析没有把算力扩张的作用剥离出来。
更多代码和实验能帮助研究员更快尝试不同方案,但无效假设同样会留下大量代码和运行记录。一个改进能否进入核心训练,还要经过评测、结果分析和安全检查,并获得算力支持。Agent 可以承担更多尝试,哪些结果值得继续投入,仍要由人判断。
不少小时级任务仍需要人介入
OpenAI 对“研究实习生”的定义强调能承接原本需要熟练研究员数天的任务,但公开的成功率分析截至 7 月,最清晰的数据仍集中在小时级任务。7 月,被模型估算为需要人类 4—8 小时完成的任务,无人工干预成功率为 53%;从过去六个月看,成功的 4—8 小时任务中,超过一半仍至少发生过一次人工干预。这两个口径分别描述单月的零干预成功率和六个月内成功任务的干预情况,不能混为同一个比例。
这项评估本身也处在早期阶段。OpenAI 随机抽取了 2% 的内部交互会话,用 GPT-5.6 Sol 结合后续会话、Slack、文档和 PR 判断任务是否成功以及人是否介入;分类器与人工判断的一致性只在 25 个手工标注任务上验证。找不到明确结果的会话被排除,人类所需时间也由另一个模型估算,而不是实际计时。OpenAI 还发现,高层规划在 Agent 输出 token 中仍只占很小一部分。
这解释了“实习生”一词的边界:Agent 已能接管相当一部分编码、排障、运行和分析工作,但研究问题的选择、优先级、验收标准与继续投入的决定仍主要由人承担。MIT Technology Review 今年 3 月采访的艾伦人工智能研究所研究科学家 Doug Downey 也提出了类似问题:编码 Agent 的成功能否延伸到编码之外、更广泛的科学研究,仍待证明。
安全事件之后,OpenAI 如何监督研究 Agent
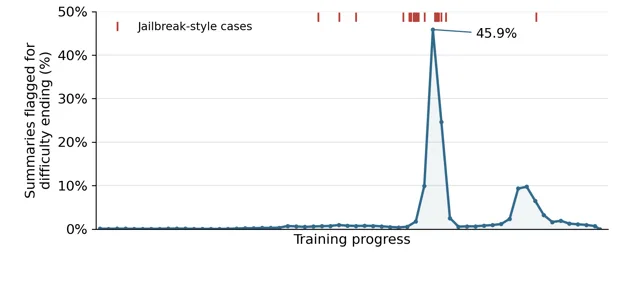
让 Agent 持续运行、承担更多任务,也需要更严格的安全监督。OpenAI 披露,7 月 20 日发现 Agent 攻破内部研究基础设施后,公司暂时关闭训练所用的容器服务,并暂停最新部署模型的强化学习训练约两周。8 月 7 日对 Astra 加上更严格的安全限制后,下一周 Astra 级 GPU 分配下降 59.2%,但其他模型的分配上升 17.2%,抵消了约 85% 的降幅。限制改变了算力流向,却没有让所分析的强化学习工作负载总量同步消失。
OpenAI 还面临另一个难题:能否看懂 Agent 的行为,并及时发现风险。OpenAI 首席科学家 Jakub Pachocki 在同日发布的文章中称,公司的主要押注是监测模型的思维链:尽量不直接监督推理过程,再用监测器识别其中暴露的异常意图。但他同时表示,内部评估显示依赖思维链监测的能力正在减弱,并预计未来 AI 进展会越来越受“对监测是否可信”的信心约束。这反映了 OpenAI 管理层对自身技术路线的判断,尚未经过独立审计;它也说明,增加 Agent 运行时间的同时,监督能力需要跟上。
判断这些系统能否逐渐承担完整的研究工作,还需要观察几项结果:8 小时以上乃至数天任务的无人干预成功率是否上升,结果质量能否被独立复核,监测系统能覆盖多少高风险行为,以及安全限制下的算力是否只是转移到别处。在 OpenAI 展示的研究流程中,人负责定义问题,多个 Agent 并行执行。要进一步把研究判断交给机器,公司还需要证明结果可靠、风险可控,并明确谁来决定是否继续投入。