2026 年 6 月 22 日,Nvidia 在汉堡 ISC High Performance 大会上公布欧洲 35 台超算项目及 Vera Rubin 科学计算系统的进展。结合此前发布的 Vera CPU,可以看到它如何为模型之外的代码执行、工具调用和任务调度配置更多 CPU 资源。
Vera CPU 面向代码执行、工具调用和任务调度
Vera 延续了 Grace 的 Arm 服务器路线。Nvidia 将其定位为「全球首款专为 Agentic AI 和强化学习时代打造的处理器」。它既可作为 GPU 系统的主机 CPU,也可组成独立服务器。Vera CPU 已在 3 月发布,6 月的公告继续介绍其在科学计算中的应用。
Vera 基于 88 颗 Nvidia 自研 Olympus 核心,完整兼容 Armv9.2 指令集,配备 176 线程。芯片采用第二代 SCF(Scalable Coherent Fabric)互联,提供 3.4 TB/s 的二分带宽和统一缓存架构。NVLink-C2C 芯片间接口吞吐量达到 1.8 TB/s——是前代 Grace 的两倍。Vera 也支持 Confidential Computing,可用于保护数据与代码的执行环境。
Nvidia 在 5 月的介绍中称,Vera 的任务完成性能可达到 x86 处理器的 1.8 倍;具体增益取决于所测任务和配置,不能套用于所有工作负载。它还支持机架级部署。
单机架支持逾 22,500 个 CPU 环境,供工具调用与代码执行
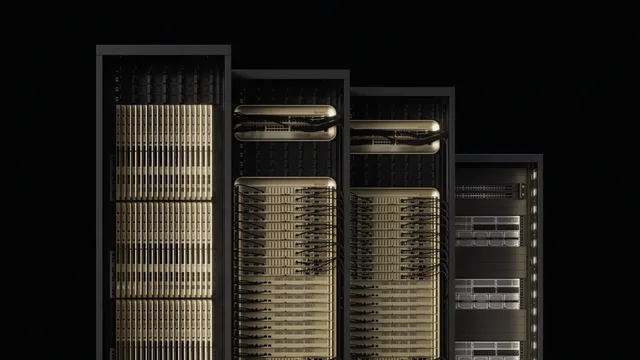
Vera CPU Rack 在一台液冷机架内集成 256 颗 Vera CPU。据 Tom’s Hardware 对该机架配置的报道,它还搭配 74 颗 BlueField-4 DPU 和 ConnectX SuperNIC 网络芯片。整机架提供高达 400 TB 的 LPDDR5X 内存和 300 TB/s 的聚合内存带宽。
这台机架可以同时维持 22,500 个以上的独立 CPU 环境,每个环境以全性能独立运行。这些环境可用于工具调用、代码执行、强化学习评估和数据流编排。它们不是对完整 Agent 数量或复杂度的统一度量:一个 Agent 可能使用多个环境,也可能还要调用外部模型和服务。
这类部署补充了 GPU 计算之外的资源需求。模型训练和推理依然需要加速器,而 Agent 运行代码、验证结果和调用工具时,也会消耗 CPU、内存和存储。Vera CPU Rack 主要面向其中需要大量并发执行的环节。
「OCI 计划从 2026 年开始部署数十万颗 NVIDIA Vera CPU,因为 Agentic AI 需要大规模持续性能,」Oracle Cloud Infrastructure 高级副总裁 Batta 表示。在此之前,Anthropic 和 OpenAI 已率先收到首批 Vera CPU。
欧洲 23 国开发 35 台超算,主要采用 Hopper 与 Blackwell
此次欧洲公告涉及 23 个国家正在开发的 35 台 AI 超算,覆盖国家级超算中心、AI 工厂和学术研究机构。官方另称,自去年以来已部署或宣布的相关 AI 算力为 800 exaflops。这一口径还包括此前公布的项目,其中部分尚未投运。
具体项目包括:巴塞罗那超级计算中心的 EuroHPC AI Factory、德国巴伐利亚州的 Blue Swan(提供高达 11 exaflops 的 AI 训练性能和 22 exaflops 的 AI 推理性能)、意大利的 IT4LIA、斯图加特 HLRS 的 HammerHAI、瑞典 NAISS 的 Mimer EuroHPC AI Factory 等。这些系统将为超过 300 万名研究人员提供下一代 AI 和 HPC 基础设施。
WCCFTech 指出,这些部署主要基于 Hopper 和 Blackwell 平台,同时 Nvidia 透露 Vera Rubin 平台也已获得「强烈兴趣」。Nvidia 同时宣布,包括 Bull、Dell Technologies、GIGABYTE、HPE 和 Supermicro 在内的全球系统制造商将提供定制化高密度 Vera Rubin 超算系统,单机架可容纳最多 144 颗 GPU。
从更大的视角看,Nvidia 在 ISC 2026 上披露,其技术已驱动 TOP500 榜单中超过 400 台、占比 81% 的超级计算机,并支撑了欧洲 90% 以上的 AI 工厂建设。HPCwire 评论称,这是欧洲大陆「历史上最大规模的单年度超算资源扩张」。
洛斯阿拉莫斯实验室三套系统,分别面向国安与开放科学
洛斯阿拉莫斯国家实验室选择由 HPE 建造 Mission、Vision 和 Veritas 三套超算系统,将采用 Vera Rubin、Vera CPU 及相关网络技术。
Mission 面向国家安全级工作负载。Vision 搭载 Vera CPU,定位于开放科学——覆盖基础模型训练、Agentic AI 以及横跨材料科学、核能、聚变能和量子计算的复杂模拟。Veritas 则结合 Rubin GPU 与独立 Vera CPU 分区,用于结合科学仿真、AI 和数据分析。
从性能数据看:单台 Vera Rubin 机架提供超过 7 exaflops 的 AI 性能和 5 petaflops 的原生 FP64 双精度算力。Nvidia 将相关系统的性能与 TOP500 榜单上的超算相比,实际榜单名次仍需经过相应测试。
此外,Nvidia 在 3 月介绍的 Vera Rubin POD 设计,将五种不同用途的机架系统(NVL72 训练推理、Groq 3 LPX 低延迟推理、Vera CPU 大规模沙盒、BlueField-4 STX AI 原生存储、Spectrum-6 SPX 硅光子网络)组合成一个 40 机架、60 exaflops 的统一 AI 工厂。这种架构设计的核心假设是:未来的 AI 工作负载不再是单一的训练或推理流水线,而是混合了 MoE 推理、RL 评估、工具调用、长上下文记忆寻址和 Agent 间通信的多阶段并行任务图。
欧洲扩建 AI 基础设施,为英伟达带来更多需求
这些项目也反映了欧洲扩大本地 AI 基础设施的需求。
过去两年,美国对华 AI 芯片出口管制不断升级,Nvidia 在中国市场的营收受到结构性挤压。与此同时,欧洲正在加速构建「主权 AI」能力——从 EuroHPC 联合计划到各国自建的 AI 工厂,欧洲对自主可控的 AI 基础设施需求快速膨胀。Nvidia 在欧洲的布局既是对市场需求的响应,也是一种地缘对冲。
Jensen Huang 在今年 3 月的 GTC 大会上曾表示:「我看到到 2027 年至少 1 万亿美元的基础设施需求。」Fortune 报道称,这个数字较此前估计翻了一倍,主要驱动力正是 Agentic AI 对推理和并发运算的爆发式需求。欧洲的项目是这一投资需求的一部分,具体收入仍要随着交付逐步实现。
CPU 可独立扩容,还要与 GPU、网络和存储协同
Vera CPU 和欧洲超算项目说明,Nvidia 正在同时提供 CPU、GPU、网络与软件。实际效率要看这些部件如何配合,不能只凭 GPU 峰值性能判断。
模型训练本身也有复杂的通信与调度;Agent 系统则进一步加入了动态的工具使用过程:一个用户请求可能触发数十个 Agent 并行运行,Agent 之间互相调用、验证输出、查询外部工具、访问存储。这要求基础设施不仅能提供峰值算力,还要能在海量并发环境中维持低延迟、高带宽和一致的数据语义。
这也是 Nvidia 扩大 CPU 投入的背景。Vera 可以与 AMD EPYC、Intel Xeon 等服务器 CPU 竞争,也可成为其 AI 基础设施中的一类 CPU 资源:与 Rubin GPU 协同,但可独立扩展,为 Agentic AI 工作负载提供专门的 CPU 容量池。
Dell、HPE、Lenovo 和 Supermicro 已承诺量产独立 Vera CPU 服务器,为客户增加了 x86 之外的选项;市场此前已有其他 Arm 服务器。连同 ASUS、Foxconn、GIGABYTE、Quanta 等代工伙伴,一个围绕 Vera 的制造生态正在成型。
性能、交付和实际利用率,仍要看部署结果
从 256 颗液冷 CPU 的机架,到支持 22,500 个并发环境,再到欧洲 35 台超算项目,Nvidia 正在把产品能力与部署计划联系起来。这些配置能否在实际项目中发挥效用,还取决于交付和运行情况。
后续更值得跟踪的是实际交付、任务完成时间、资源利用率与运行成本。CPU 容量增加能解决多少等待,还要由具体 Agent 工作流和科学计算任务来检验。