同一份规则更新里,Anthropic 同时做了两件方向相反的事。10 月 8 日,公司宣布新版 Usage Policy 将于 11 月 12 日生效:Claude 不再一概禁止个性化投票与竞选定向;但当模型绕过逐次人工批准,直接控制可能致伤的车辆、机器人、工业设备或医疗装置时,部署者必须让合格操作员随时看得见、停得下,并保证断开 Claude 后设备仍能停止或保持安全状态。
这不是一边“放松”、另一边“收紧”的偶然拼接。它体现了 Anthropic 正在改变划线方法:不再仅凭“政治内容”或“机器人”这样的类别判断风险,而是追问信息是否通过欺骗和个人数据滥用影响人,模型输出是否会未经批准变成现实动作,以及事故发生时有没有独立于模型的刹车。
政治内容不再一律挡在门外,欺骗和数据滥用仍是红线
Anthropic 在 2025 年 8 月的政策更新中,已经把早期“所有游说或竞选内容均禁止”的规则缩小为三类问题:欺骗或破坏民主程序,以及选民和竞选定向。2026 年的新版本又删除了最后一项 blanket ban——对个性化投票与竞选定向的一刀切禁令。
公司的理由来自两个很具体的场景。公益组织可能需要把选民信息改写成其他语言;选举官员也可能根据个别选民的材料缺失情况,发送 ballot cure notice,提醒他们补救有问题的选票。旧规则只要看到“个性化”和“选举”同时出现,就可能把这些正当服务与操纵性定向一起拦下。
新规则没有把政治传播变成无条件开放区。Claude 仍不得用假账号、冒充候选人或选举机构、隐瞒信息赞助者、伪造独立媒体、散布错误投票地点,或者用欺骗与恐吓压低投票率。政治定向若依赖未经允许的私人信息、非自愿追踪或个人画像,也会落入隐私与监控禁区。换句话说,“给不同群体写不同版本”本身不再自动违规;内容是否虚假、身份和赞助是否透明、数据从哪里来、信息是否在操纵参与权,才决定它能否通过。
这条边界也说明,新版不是政治广告平台的准入许可。政策只规定用户能否调用 Claude,并不替代各地关于竞选广告、披露、个人数据和自动通信的法律,也没有承诺第三方分发平台会接受这些内容。TechCrunch 同日的报道确认了欺骗活动和选举干预禁令,但 Anthropic 没有同步公开政治定向的检测口径、误判率或申诉样本。
危险硬件的“人在环”变成了运行时刹车
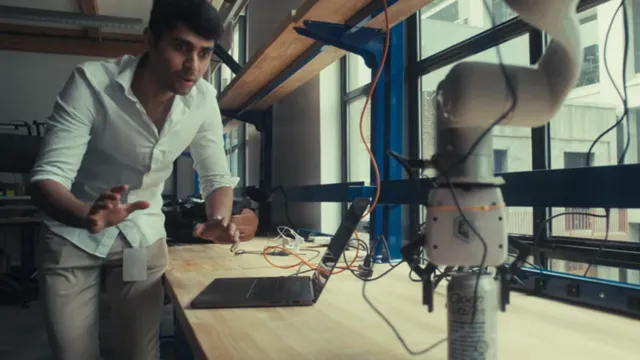
政治内容的风险通常在信息传播后显现;物理设备的错误可能立即变成碰撞、挤压、过热、过量给药或安全系统失效。新版因此新增“高风险物理动作”要求,覆盖六类未经人工逐次批准便会执行的动作:在有人空间移动的车辆、无人机和移动机器人;可能击打、挤压或坠物的机械;高压、高温、高电流、激光、辐射及危险材料;直接作用于人体的给药和医疗装置;消防、急停、通风、门锁等安全系统;以及故障会伤及工人或公众的工业流程。
这里的“人在环”不是在任务开始前点一次同意。规则要求合格操作员能够观察设备运行,并在任何时候停止它;人在介入或模型连接丢失时,设备必须停止或保持安全态。速度、作用力、活动范围、温度、压力、电压、能量、剂量等安全边界,还必须由设备本身或独立控制器执行,不能依赖 Claude 在下一轮推理中自觉遵守。
这相当于把安全责任拆成三层:模型可以规划和调整动作,操作员承担持续监看与制动责任,确定性的控制器则守住模型不能改写的物理上限。网络中断、提示注入或模型误判都不应让最后一层失效。对正在把 Agent 接入实验室和工厂的团队而言,合规工作因而不只是写提示词和做模型评测,还包括急停回路、断联行为、权限隔离和独立限幅是否真的存在。
规则也明确排除了几种低风险或仍由人批准的情况:最坏结果只是轻微不适或不便、且运行在制造商内置安全范围内的家用设备;由合格人员在执行前复核的代码、工具路径和指令;只监测而不控制设备的系统;以及在封闭仪器内处理非危险材料的实验室自动化。是否触发要求,关键不在设备是否叫“机器人”,而在模型输出会不会跳过人工批准直接驱动可能致伤的动作。
从 Model Hardware Standard 到 Usage Policy,接口开始携带安全责任
硬件条款并非凭空出现。Anthropic 8 月开放 Model Hardware Standard(MHS)研究预览,希望用统一驱动把显微镜、移液器、机械臂和量子设备接入 Agent。MHS 让设备暴露读取、写入和安全限制等信息,Agent 可以跨设备编排实验、实时调参,并把学到的步骤封装为确定性脚本继续运行。
能力扩大也改变了失控方式。Anthropic 自己承认,Claude 对物理世界的空间和物理推理仍有限,需要专家监督;在 Genentech 的测试中,研究人员还要提示模型,样本起泡是需要物理处理的问题,而不是软件故障。新版 Usage Policy 把这类工程经验从研究预览推进成面向所有 Claude 集成者的最低条件:凡是把模型连接到高风险动作,不能只在接口描述里告诉模型“注意安全”,还要在模型之外保留可观察、可制动、可失联降级的控制链。
这也是政治个性化与硬件控制看似无关、实则共用的判断逻辑。前者允许根据对象调整内容,但不能用欺骗、隐藏身份或滥用个人数据去消灭对方的知情选择;后者允许模型自主选择动作,但不能让模型同时掌握执行权和最后一道安全边界。两边都不是禁止自动化,而是要求自动化不能拿走受影响者或责任人的关键控制权。
规则写清了责任,却还没有证明执行效果
Anthropic 表示,Usage Policy 适用于 Claude.ai、Claude Code、API、云服务商和授权经销商,也覆盖把 Claude 集成进产品的终端用户。Safeguards Team 会用检测与监控执行规则,并可警告、限流、暂停或终止访问。公司透明度页面披露,2026 年上半年共封禁 1140 万个账户,收到 39.8 万次申诉,其中 4.2 万次推翻原决定。
这些总量不能证明新版边界已经可执行。公开数据没有把封禁拆分到选举、隐私、武器、硬件或地区限制,也没有说明 API 与第三方集成中的高风险物理动作如何被识别。设备是否有独立限幅、操作员能否持续观察、断联后进入什么状态,往往存在于客户现场的控制系统中,模型供应商未必能从一段提示词或一次 API 请求看见。
政策本身也不是法律或安全认证。它明确要求部署者同时遵守车辆、航空、医疗器械、机械和工作场所安全规则;对某些政府客户,Anthropic 还保留在其认为保障措施足够时,通过合同调整使用限制的空间。因此,企业不能把“符合 Usage Policy”当成设备获准上市、工作场所风险评估完成,或竞选内容已经满足当地披露义务的替代品。
11 月 12 日之后,真正值得检查的不是 Claude 会不会多拒绝几条请求,而是两条责任链能否留下可核验记录:竞选团队能否说明个性化所用数据、赞助者身份和分发方式;硬件部署者能否现场证明操作员看得见、急停有效、断联会进入安全态,且物理边界不受模型输出控制。只有这些证据出现,“按后果划线”才从一份平台政策变成实际的治理能力。