拜耳与 Thoughtworks 开发的科研平台 PRINCE,已经从统一搜索工具扩展到自然语言问答和多步骤研究任务。2026 年 6 月 16 日,Thoughtworks 工程师 Sarang Sanjay Kulkarni 在 Martin Fowler 网站发表案例,介绍系统如何处理临床前研究数据,以及上线后如何追踪证据、评估回答和恢复失败的任务。
数万项研究的数据散落在不同系统中
临床前药物研发需要分析大量历史数据。拜耳的科研人员需要查询数十年积累的超过 18,000 项非临床研究的数据——这些数据分散在多个彼此隔离的系统中,既有高度结构化的实验数据集,也有大量以扫描 PDF 形式存在的非结构化研究报告。由于历史上多次系统迁移,部分结构化元数据已不完整甚至错误,团队将经过审批的 PDF 研究报告作为核对信息的权威来源。
传统的基于关键词和布尔逻辑的搜索工具在面对这些复杂、充满术语变体的科研问题时力不从心。研究人员往往需要耗费大量时间手动翻阅报告、交叉比对数据,才能回答一个看似简单的问题——比如"某化合物在特定剂量下是否出现某种临床观察症状"。
这正是 PRINCE(Preclinical Information Center)的起点。
从筛选元数据,逐步扩展到问答与文档起草
PRINCE 分阶段增加了检索、问答和执行多步任务的能力:
Search 阶段(2021 年起):最初,PRINCE 只是一个统一的数据网关,将分散在多个内部系统中的结构化研究元数据整合到一个可搜索的界面中。用户可以通过高级筛选器查找研究,但核心能力仍局限于结构化元数据的匹配。
Ask 阶段(2024 年 3 月):随着大语言模型和 RAG 技术的成熟,PRINCE 引入了基于自然语言的问答能力。系统不再只是返回匹配的元数据,而是能够直接"阅读"PDF 研究报告的内容,理解科研人员的自然语言问题,并给出基于原文证据的回答。它还可以匹配用词不同但意思接近的表述。例如,当用户查询"piloerection"(竖毛)时,系统能自动识别报告中"Fur erected"(毛发竖立)等同义表述。
Do 阶段(2024 年 11 月):PRINCE 引入多 Agent 协作,扩展为能够执行多步骤任务的科研助手。系统不仅能回答问题,还能执行复杂的多步骤任务:分解复杂查询、跨多个研究并行检索、综合信息生成结构化回答,也能辅助起草 IND(Investigational New Drug,新药临床试验申请)材料,由研究人员审核。
五个工作环节分别规划、检索和检查回答
PRINCE 的核心工作流由 LangGraph 编排,包含五个关键环节:
Clarify(澄清意图):用户问题模糊时,系统先询问要查的领域和数据类型。在毒理学、药理学等场景中,相同术语可能指向不同数据。先澄清范围,可以减少在不相关来源中反复检索,让后续 Agent 收到更具体的问题。
Think & Plan(思考与规划):这一步受到 Anthropic Think Tool 的启发。它提供了一个专门的"思考空间",让系统在执行任何工具调用之前,先进行流程反思(Process Reflection)——当前路径是否正确?是否在朝着目标前进?工具选择是否恰当?
随着 PRINCE 接入的数据源越来越多,工具数量急剧膨胀,不同工具之间出现了功能重叠和边界模糊。例如,多个工具可能在处理"研究"相关的查询,但分别指向结构化元数据、非结构化报告或汇总数据。Think & Plan 使系统能够显式地推理哪个工具最匹配用户意图,拜耳团队报告称这一步"显著提高了工具选择的准确性"。
Researcher(研究员):这是系统的信息获取主力,采用双轨策略——RAG 处理非结构化 PDF 报告,Text-to-SQL 查询 Amazon Athena 中的结构化数据。RAG 管线尤为精细:关键词提取、元数据过滤生成、查询扩展(n=5 个语义变体)、加权混合检索(语义搜索权重 0.7,关键词搜索 0.3)、跨编码器重排序(bge-reranker-large,从约 20 个候选块中选出前 7 个),最终由推理模型生成带引用的回答。
随着领域扩展,拜耳正在将 Researcher 从单一 Agent 演进为领域子 Agent 的层级结构——毒理学、药理学等各自拥有定制化的工具集和提示指令,顶层 Researcher 仅作为协调者进行路由。
Reflection(反思):这是第二层反思——数据反思(Data Reflection)。Reflection Agent 评估已收集的证据是否充分、相关,是否足以回答用户的问题。如果发现信息缺口,它会生成具体的后续问题,交还给 Think & Plan 发起新一轮检索。它把证据是否充分与工具调用流程是否合理分开检查。
Writer(撰写):Writer Agent 负责将检索到的原始证据合成为最终答案。它有几条硬性规则:每一条断言必须基于提供的上下文,并附带精确的引用(链接到源文档、页码和原文摘录)。用户可以通过回答中的引用查看对应出处。对于更复杂的输出——如多章节摘要或监管文件草稿——Writer 还支持一个轻量级的内部审查循环,即草稿反思(Draft Reflection):检查遗漏的章节、不一致的表格或合成缺口。
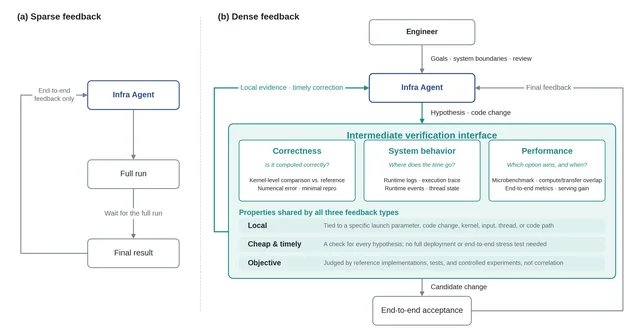
这三类检查分别关注执行路径、证据充分性和草稿完整性,让团队能够定位问题出在哪个环节。
各环节只接收完成任务所需的上下文
PRINCE 团队发现,即使上下文窗口变大,仍需筛选送入模型的信息。在早期迭代中,将过多信息塞入上下文反而让系统更难操控、更难评估。
团队按任务阶段分配上下文,让每个 Agent 接收不同的信息:
- Think & Plan 获得规划上下文(当前目标、可用工具、历史轨迹)
- Researcher 获得检索上下文(用户意图、领域约束、工具描述)
- Reflection Agent 获得证据上下文(原始问题 + 已收集数据,而非完整工作流历史)
- Writer Agent 获得合成上下文(精选后的 chunk + 引用约束,而非原始检索输出)
这种分配方式也影响了具体实现:Text-to-SQL 步骤只注入与当前查询相关的 schema 组件,而非完整数据库 schema;Reflection Agent 看不到完整的工作流历史,只看到问题和证据的对比。从单体 Agent 到结构化工作流,每个 Agent 可以独立评估、调试和改进。
重试、备用模型和状态存储支持故障恢复
PRINCE 在模型调用与工作流之外设置了多种恢复和监测机制:
备用模型与平台切换:系统通过内部 GenAI 平台接入 OpenAI、Anthropic、Google 以及开源模型,所有模型通过统一的 OpenAI 兼容端点暴露。当某个 LLM 调用失败后,系统自动重试数次,然后切换到备用模型或平台,减少单个供应商故障带来的中断。
双层重试机制:重试在 LLM 调用级和逻辑节点级(即工作流中的一个完整步骤)同时实现。这意味着不仅是单个 API 调用的瞬时故障可以恢复,整个步骤的失败也能被捕获并重试——而且 Agent 会收到错误上下文,能够据此调整策略。
状态持久化与断点续跑:Agent 状态通过 LangGraph checkpointer 持久化到 PostgreSQL,应用级状态(日志、中间步骤、引用)存储在 DynamoDB。工作流失败后,可以利用已保存的状态继续执行,无需重跑已完成的步骤。用户甚至可以手动触发重试,系统会自动跳过已成功完成的步骤。
可观测性与评估:CloudWatch 追踪系统健康指标,Langfuse 提供全链路生产流量追踪。系统使用 RAGAS 框架进行双轨评估:数据集评估(由领域专家标注的参考回答)在核心工作流、提示或模型变更时触发;线上流量评估每天以批处理方式运行,监控回答是否忠实于检索证据(Faithfulness)、是否切合问题(Answer Relevancy)等指标。
展示执行过程和出处,方便科研人员核查
在临床前药物研发中,AI 输出的可信度直接影响决策质量。PRINCE 因此向用户展示执行过程与引用来源:
系统展示每一步执行的操作、使用的工具和检索的文档。用户可以查看回答所附的源文档链接、页码和原文摘录,沿着引用核查结论,而不必重新搜寻整份报告。
团队在 2025 年发表的论文中报告,各阶段向 15–20 名频繁使用系统的内部用户收集了反馈。平台与聊天界面的平均易用性评分为 4/5,75% 的受访者表示搜索信息所需时间显著减少。团队还报告,多 Agent 系统上线后复杂查询的响应时间平均改善 30%。不过,聊天机器人在“完全满足用户需求”上的平均评分为 3.1/5,仍有改进空间。
可借鉴的是任务分工与核查机制,仍需适配具体业务
PRINCE 处理的是一组在大型组织中常见的问题:历史数据分散、质量不齐,用户需要准确答案,也需要知道答案来自哪里。金融合规和法律文书等工作可能面临相似需求,但数据权限、专业判断和审核要求各不相同。
拜耳团队的做法是先整合搜索与数据,再加入问答和多步任务;将规划、检索和撰写拆开,为各环节提供相应上下文,并单独评估和调试。备用模型、双层重试与状态存储则处理模型之外的运行故障。这些机制需要与业务流程共同设计。
Kulkarni 用两个概念回顾这些决策:上下文工程决定模型看到哪些信息,以及信息如何在各步骤间传递;**运行框架工程(Harness Engineering)**负责工作流、工具权限、状态存储、重试、备用方案、验证、监测和人工审查。它们共同支撑系统运行,而非依赖单个模型完成全部工作。
团队正在将 Researcher 扩展为按领域分工的子 Agent,并使用命名实体识别(NER)从 PDF 报告中提取和修正元数据。接下来的改进仍围绕两个具体问题:检索能否找到正确证据,以及科研人员能否方便地核查并使用回答。