MiniMax H3 开放权重之后,开发者开始优化它的视频生成速度。8 月 27 日,FastVideo 联合 Nuva Lab、NVIDIA 团队发布 FastH3 Preview v1,把有声视频生成中的反复去噪压缩到四轮。9 月 2 日,团队又给出 Mac 和 NVIDIA DGX Spark 的本地运行方案,其中 Mac 路径要求至少 36GB 统一内存。发布说明、本地运行说明。
创作者因此可以在自己的设备上反复改提示词、生成有声短片。实际等待时间还包括提示词编码、权重加载和画面解码,“四步”对应的是其中的去噪过程。FastH3 的本地方案也对这些前后环节做了优化。
重新训练模型,把去噪缩短到四轮
扩散模型从噪声开始,反复调整内部的视频和音频表示,逐渐形成内容。直接减少原模型的运行轮数,也会减少它修正结果的机会。FastH3 重新训练了一个学生模型,让它学会用更少的修正完成生成。
其训练方法来自分布匹配蒸馏 DMD2:保留一个能力较强的教师模型,再用一个持续学习的评估模型估计学生当前的生成分布。两者给出的信号差异,告诉学生应该怎样调整输出。训练还会让学生经历自己实际推理时产生的中间状态,减少“训练时见到的输入”和“部署时自己生成的输入”之间的偏差。这是 DMD2 论文 对多步蒸馏的关键处理。
FastH3 的推荐版本直接用提示词训练,不预先收集目标视频,训练过程中由教师和评估模型提供信号。发布名称中的 Data-Free 指的就是省去预先收集目标视频这一步。四轮生成依赖重新训练后的权重,给原版 H3 调低步数,并不能获得同样的结果。FastH3 方法说明。
用稀疏注意力,减少视频区域之间的计算
视频模型需要比较不同时刻、不同位置的内容,才能维持动作和对象的联系。视频越长、分辨率越高,需要比较的组合就越多。减少去噪轮数后,每一轮里面的这些比较仍然昂贵。
视频稀疏注意力 VSA 先把视频表示分成若干小块,用较粗的表示挑出相关区域,再对选中的区域做细致计算。这样既减少了比较次数,也让计算保持适合 GPU 执行的块状结构。VSA 原始论文 同时研究了训练和推理阶段如何采用这种计算方式。
FastH3 推荐版本在可稀疏的视频块关系中,只保留约一成参与注意力计算;文本和音频部分继续使用密集注意力。它省下的是视频区域之间的比较,保留了全部视频帧。发布说明。
稀疏计算需要配套的运行库。FastH3 的稀疏版本包含 VSA 参数,发布的 LoRA 也带有相应增量,无法像普通适配器一样直接接入密集注意力后端。模型卡 对这些配置作了区分。
四步蒸馏减少模型运行的次数,稀疏注意力减少每次运行的计算量。FastH3 推荐方案同时用了两种方法,因此它的整体加速效果,也取决于权重和运行后端是否配套。
分阶段加载,让 36GB 内存的 Mac 也能运行
模型权重能放进内存,还不够完成生成。提示词编码器、去噪模型、视频与音频解码器,以及运行中的中间结果,都要占用空间。
FastVideo 在 Mac 上安排它们轮流进入内存:先编码提示词,释放编码器;再加载生成模型,完成去噪后释放;最后加载解码器,输出同步的画面和声音。Spark 也采用分阶段加载。统一内存由 CPU 和 GPU 共享,把权重复制给 CPU 并不会腾出另一块独立的物理内存,还可能制造副本。本地运行说明。
内存较小的机器由此可以用加载时间换取运行空间。连续试稿时,复用进程和已有结果则能减少重复工作。例如,同一提示词的编码可以缓存;改了提示词,就要重新编码。
两组同机对比:Spark 上约快 7 倍,RTX 5090 上约快 5.7 倍
FastVideo 在单台 DGX Spark 上比较了两套方案:生成 1024×576、124 帧的视频,原版 H3 的 50 步配置用时 1881 秒,四步 FastH3 用时 268 秒,约快 7 倍。设备与输出尺寸相同,差异包括蒸馏方法及运行实现。原始记录。
生成平台 Sogni 则在 9 月 2 日公布了 RTX 5090 的测试:用同一张浴缸黑猫照片,生成约 15 秒的竖屏有声视频。768×1024 配置下,20 步标准档用时 11 分 55 秒,四步 FastH3 用时 2 分 6 秒,约快 5.7 倍。两档采用的量化方式不同,比较的是平台提供的完整配置。Sogni 测试。
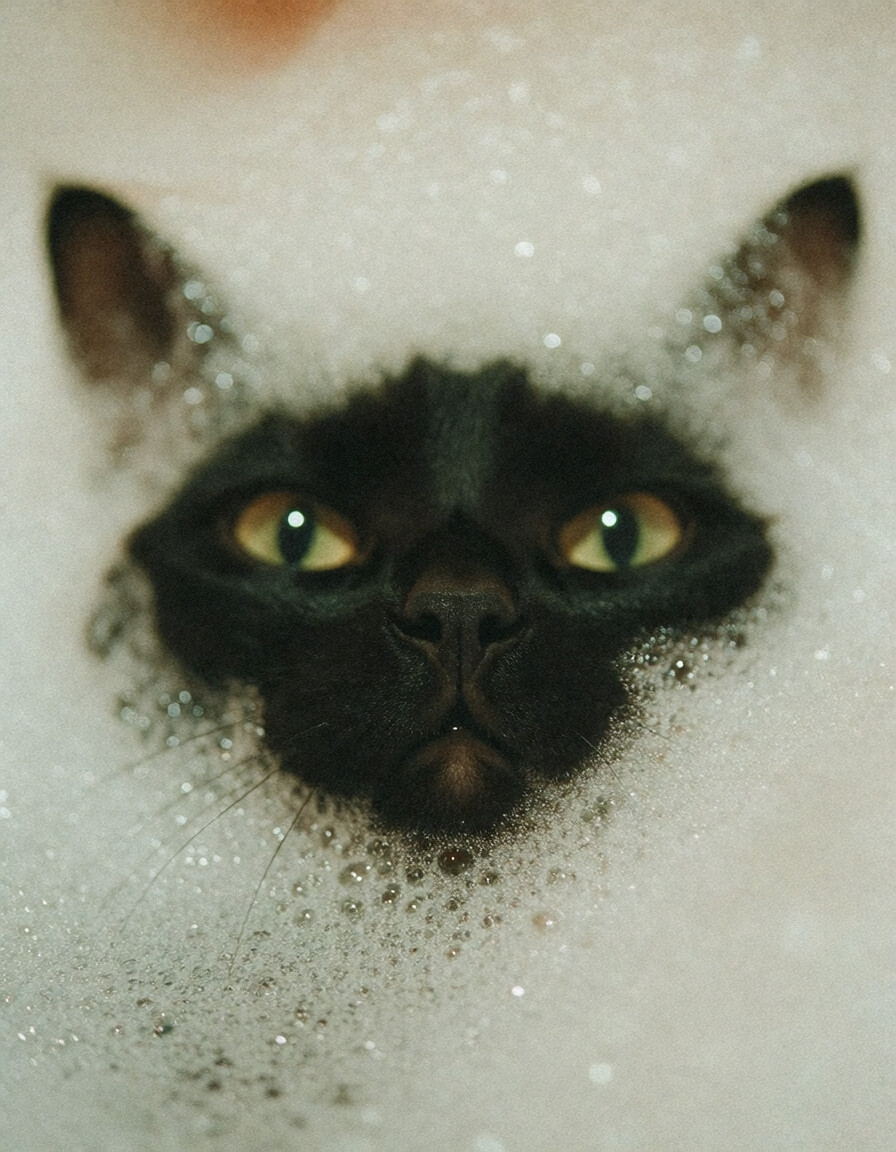
这是 Sogni 视频测试使用的输入照片,来源:Sogni。
Sogni 从任务开始计时到 MP4 完成,包含解码、编码和上传,排除排队与模型加载。它记录了两次运行,图表采用第二次,接近服务已经启动后完成一次请求的等待时间。这是平台自行报告的单个案例,输入图片和提示词均已公开。
Sogni 的图生视频功能还包含平台自己的实现。FastH3 Preview v1 模型卡列出的支持范围是文本生成视频和音频,学生模型没有接受首尾帧条件训练;Sogni 将它接入了自己的图生视频流程。权重本身的训练范围,与平台支持的输入方式,在这里有所不同。
轻量解码从 104 秒缩到 1 秒,整次生成仍需数分钟
去噪产生的是压缩的内部表示,解码器负责把它还原成真正的画面。轻量解码器 TAEH3 可以更快完成这个步骤,其代价主要落在重建细节上;它属于 TAEHV 项目 支持 MiniMax H3 的实现。
在 FastVideo 的 M4 Max 对照中,完整视频解码需要 104 秒,TAEH3 只用 1 秒;整次生成则从 451 秒缩短到 350 秒。按总耗时计算,加速约为 1.29 倍。团队给出的画面取舍是头发、织物和远景细节变软。解码对照。
解码快上百倍后,整次生成仍要几分钟,因为剩余工作也要花时间。Sogni 的低分辨率 FastH3 测试也有类似结果:55 秒总耗时中,采样占 26 秒,后续处理占 29 秒。继续减少去噪步数,能影响的已不到一半。
启动时间也会影响比较结果。FastVideo 的四块 GB200 展示将 350 秒模型启动时间排除在请求计时之外;Spark 的重复请求则仍会重新加载部分组件。两者虽然都是“第二次生成”,复用的工作却不同。计时说明。
对反复调整分镜的创作者,轻量解码适合先看构图、动作和声音安排,完整解码则保留更多画面细节;连续工作时复用服务进程,可以减少每一稿的启动时间。FastH3 缩短了去噪过程,本地试稿到底快多少,还要看片长、分辨率,以及加载、解码等环节占用了多少时间。