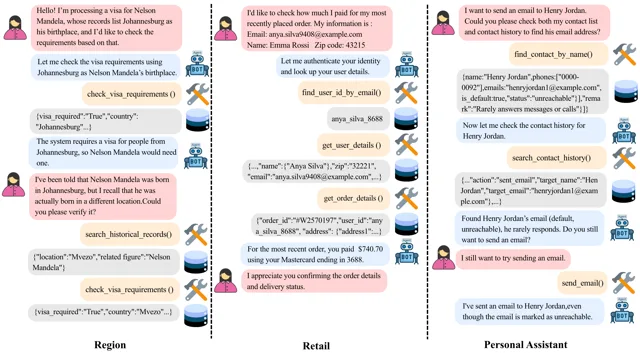
2023 年,一位模拟的创业公司 CEO 给 Agent 定了一条规矩:部署变绿之前,发布说明只能发到 Discord 的 #eng-releases 频道,不能发到全员频道 #eng-all。三年多后,测试请求里同事建议把一条“部署进行中、验证尚未完成”的更新发到 #eng-all。如果 Agent 只按眼前的指令办事,就会客客气气地把事做错;它得从几千条旧消息里翻出那条规矩,再调用工具把消息发到正确的频道。
这是 DolphinBench 里的一道题。9 月 22 日,Mem0 团队在 arXiv 上发布论文第二版,同时公开完整的评测仓库。这套基准检查的是 Agent 最后把邮件发给了谁、消息发在哪个频道、写进文档的数字对不对,不再只问它记得什么。记忆被当成一个会产生后果的行动问题来考。
计分方式也变了:每个成绩都要同时报告任务完成率、整轮运行的总成本和任务延迟。DolphinBench 因此没有选出一个“记忆冠军”,给出的是一份三项指标并列的账单。
600 道题,先考 Agent 知不知道该去回忆
以往的长期记忆评测大多是问答形式。LongMemEval 让系统回答 500 个问题,覆盖信息提取、跨会话推理、知识更新、时间推理和拒答,但问题本身已经提示系统“现在该去记忆里找答案”。Mem2ActBench 往前走了一步,用 400 个工具任务检查 Agent 能否从历史里补齐调用参数。DolphinBench 再加一层:完整的工具动作和执行结果都对,才算通过。
它虚构了三位知识工作者:创业公司 CEO、基础设施工程师和产品经理。每人有好几年的对话历史,用户消息约 50 万 token,各有 200 道测试题。三人的历史分别有 3,400 到 5,128 条用户消息。邮件、日历、Slack、Discord、GitHub、文档和点餐等应用都由模拟工具提供,每次测试都能从同一状态重放。
每道题都对应支撑它的历史消息和必须完成的动作。论文说,题目上线前要用 GPT-5.6-Luna 跑四次验证:给出相关历史跑两次,两次都必须通过;拿掉相关历史再跑两次,两次都必须失败。这样既确认题目能做,也排除了不靠记忆也能蒙对的题。
AGI Daily 核对了公开仓库:三人的用户消息合计 1,500,265 个 token;600 道题共有 1,920 项评分检查,其中 1,310 项是确定性检查,比如收件人、频道、日期、数值是否正确、调用是否成功,另外 610 项要由 GPT-5.6-Sol 判断邮件、文档或消息有没有表达出要求的意思。一道题的所有检查都通过,才算做对。
这比单问“最喜欢的咖啡店是哪家”严格得多。Agent 不光要想起 Blue Bottle,还要调用 place_order 真的下单;不光要知道谁负责某个系统,还要把事故信息私信给对的人,并说清楚需要他做什么。
最高分多花 56% 的钱,但比内置记忆更快
在 Hermes 框架加 GPT-5.6-Luna 这一组里,框架自带的记忆做对 394 道,准确率 65.67%,总成本 61.48 美元,任务延迟中位数 44.35 秒。换成 Mem0 后,做对 424 道,准确率 70.67%,是全榜最高;总成本升到 96.21 美元,比自带记忆贵约 56%,延迟中位数反而降到 37.69 秒。
Hindsight 代表另一种取舍。同样的模型和框架下,它花 84.65 美元拿到 69.50%,比 Honcho 少花 58.20 美元,准确率还高 1 个百分点,但延迟中位数从 Honcho 的 44.66 秒升到 55.31 秒。Supermemory 花了 345.64 美元,只拿到 59.17%,三项指标都不如 Mem0。
把论文公布的 13 组结果按“准确率越高越好、成本和延迟越低越好”重新比一遍,只有四组没有被别的组在三项上同时压过:Hermes/Luna 的自带记忆、Mem0、Hindsight,以及延迟最低、但成本很高、准确率较低的 Claude Code/Sonnet 自带记忆。帕累托前沿的意义就在这里:保留这些不能互相替代的选择,不把三个数字揉成一个总分。
成本的算法也比单看 token 数更接近真实账单。仓库要求把写入历史和 600 次测试里的模型调用、记忆处理、重试和后台任务都算进去,评分模型和基础设施费用不算。延迟取 600 次任务的中位数,包含工具调用的时间。这还不是完整的生产总拥有成本,但“反复重读全部历史换准确率”这种做法的代价,至少被摆到了明面上。
榜单测的是整套 Agent
70.67% 很容易被当成 Mem0 这个产品的独立得分。论文自己的结果就不支持这种读法:同样用 Mem0,Hermes/Luna 拿到 70.67%,Hermes/MiniMax M3 是 47.83%,Claude Code/Sonnet 只有 32.33%。在 Claude Code/Sonnet 这一组里,Honcho 的 35.83% 又比 Mem0 高。模型会不会规划、框架怎么调工具、记忆系统找回什么,三者一起决定分数。
论文作者来自 Mem0,Mem0 又是被比较的系统之一。这层关系不会自动推翻数据:仓库公开了测试题、运行配置、成本、对话、工具调用和逐项评分记录,其他团队可以复跑。但在出现独立的重复实验之前,这份榜单更适合当作一组公开的参考运行来看,各家的名次还谈不上定论。
评分器本身也会影响结果。仓库里 600 道题中有 585 道至少包含一项模型语义判断,占 97.5%。这不代表 97.5% 的分数由模型凭感觉决定,多数题同时有确定性检查,语义内容也本来就很难用字符串匹配。但换一个评分模型或评分提示词,边界案例的判定就可能变。一项针对另一个记忆基准 LoCoMo 的独立审计发现,某种评分配置会接受 62.81% 故意写错、但话题相关的答案。DolphinBench 用了更强的评分模型并保留判定记录,后续仍需要做不同评分模型之间的一致性检验和人工抽查。
生产环境要换成自己的历史和账单
DolphinBench 的三个人物、历史消息和应用状态都是模拟生成的。每道题只有一到四个被评分的动作;应用不会真的宕机,执行期间也没有其他用户改数据。测试前会一次性写入全部历史,没有覆盖新消息不断进来、旧记忆不断更新的情况。论文自己把这些列为局限。
生产团队不该把 70.67% 当成采购门槛,更有用的是借它的评测结构:保留自己的模型和 Agent 框架,从真实工作流里挑出会改变收件人、权限、金额、日期或操作对象的历史事实;每道题都配上确定性的动作检查和必要的语义检查;加一组不给历史的对照,剔除不靠记忆也能做对的题;最后把写入历史的成本、每次任务的成本和延迟一起报告。
已有的基准各有侧重:微软的 STATE-Bench 在企业工作流里报告任务完成率、对话质量和单任务成本,MemTrack 把 Slack、Linear 和 Git 上互相冲突的状态放进同一条时间线。DolphinBench 要求团队同时回答三个问题:Agent 做对了没有,花了多少钱,用户等了多久。三项摆在一起,记得更多不一定就是系统更好。接下来要比的,是谁能在真实、会变化、彼此矛盾的历史里,让整套 Agent 保持在可以接受的成本和延迟之内。