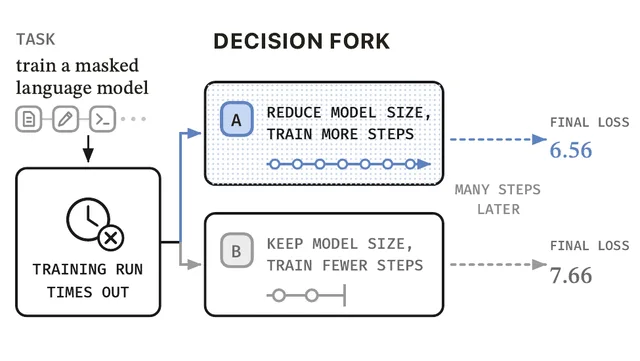
一笔 24.99 美元的订单已经结算,结算消息却没有到达支付处理器。负责处理异常的程序策略只看见“仍在等待”,最后没有发货,商户因此损失 28 美元。若归因工具只能改写 Agent 的动作,它会说:第 0 步就应该发货,并把 28 美元全部记到这个决策头上。CausalLoss-Fin 对同一轨迹同时修复消息链路后,给出的结论相反:这笔损失全部来自基础设施,其中丢失的结算消息和乱序的银行消息各承担 14 美元。
这不是两种算法算出了不同分数,而是两种模型允许追问的对象不同。2026 年 9 月 22 日提交的 CausalLoss-Fin 把延迟、重复、丢失、乱序、账本半提交和陈旧读取拆成可单独修复的消息变量。它要说明的不是“Agent 都没有错”,而是一个更基础的工程问题:如果归因系统的变量表里只有 Agent 步骤,基础设施故障即使真实存在,也没有名字可以被找到。
归因工具能怪谁,先由变量表决定
反事实归因的基本动作,是替换轨迹中的某一步,再把后续过程重放一遍。Causal Agent Replay(CAR)会重新采样某个 Agent 步骤,观察失败概率如何变化;CausalFlow 则替换候选步骤,验证哪项最小改动能把失败翻转为成功。二者都把“哪一步决策导致失败”作为问题中心,这对定位推理或工具调用错误很有用。
CausalLoss-Fin 没有否定这种方法。它增加了另一组可干预对象:Agent 当时收到的每一条消息。FinalityBench 的隐藏事件日志会向支付处理器、复式账本、ERP 和银行流水投射不同视图,故障发生在投递链路上。研究者可以在相同订单、随机种子和策略下,只恢复一条被丢弃或延迟的消息,再观察损失是否消失。
这一区别带来一个结构性结论:只允许干预 Agent 步骤的方法不可能输出“某条消息丢了”。论文构造的 agent-only 基线在基础设施案例上的 0% 识别率不是抽样运气,也不是实现失误,而是输出空间里根本没有这类答案。
三段式分解把“谁的错”改写成三个可验证问题
作者把一次策略损失拆成三项。第一项比较现实故障世界与消息全部修复后的同一策略,得到基础设施效应;第二项比较修复世界中的当前策略与最佳可实现策略,得到策略差额;第三项是最佳策略在修复世界里仍无法避免的损失。
三项首尾相消,公开实验在 3852 个 episode 上全部通过恒等式检查。这个分解的价值不只是“总和对得上”,而是把三种修复动作分开了:改善消息投递、改善策略,或承认在截止时间前信息尚未产生,任何不使用特权信息的策略都无法避免损失。
这些量不是非负占比。基础设施故障有时反而会阻止一个激进策略过早行动,公开结果中 optimistic 策略的基础设施效应为 -6.8%;当前策略也可能在个别任务上胜过选定的参考策略。把这些有符号的量写成“责任占比”,会掩盖它们可能相互抵消的事实。
11.4 万美元误责,来自 545 个植入案例而非生产事故
为了让答案可核验,作者先从策略能够正确完成的任务出发,再植入已知原因。汇总三种确定性策略后得到 545 个案例:169 个只有一个消息原因,126 个需要两个故障共同出现,70 个存在“任一个故障都足以造成损失”的过度决定,另有 180 个确实由 Agent 策略导致;每个案例还加入了经验证无害的干扰故障。
在这组生成数据里,agent-only 基线把全部基础设施案例归给 Agent,共错误记账 114,383.40 美元。这个数字是植入案例中被错分的基础设施损失总额,不是某家公司真实损失,也不是常见事故率。
更有操作意义的是修复结果。用于修复评测的 238 个基础设施 episode 一共有 82,488.60 美元可追回损失:修复 agent-only 所指认的对象追回 0%;逐条测试单个消息能追回 82.4%;搜索最小充分修复集追回 100%。后者平均只需 2.3 次重放,而给每条消息做完整 Shapley 分配需要 280.1 次。若事故复盘的目标只是回答“修什么”,完整责任分账可能是一笔没有必要的计算开销。
单条消息的效果也不总能相加。320 个存在基础设施损失的 episode 中,27.8% 的总效应不能由逐条修复效果相加得到,95% 任务聚类 bootstrap 区间为 23.3%—32.3%;其中 5.6% 的案例里,每条消息单独修复都没有效果,必须联合修复。公开代码当前版本的 17 项测试和九组实验可以复现 545 个植入案例、3852/3852 恒等式检查、两组金额与这些交互比例。
可精确重放,既是优势也是适用边界
这些结论成立在一个特意做成确定性的模拟支付环境里。论文没有调用语言模型,所谓 ReAct 只是手写的观察—决策循环;没有真实支付处理器参与,消息延迟与故障频率也不是生产统计。确定性使“恢复这条消息会怎样”只需重放一次,却不能回答随机 LLM 在相同上下文里重新采样后会怎样。
结果还依赖一个更窄的系统假设:基础设施只通过改变 Agent 能看见的信息造成损失。如果故障能直接移动资金、破坏外部状态,因果图还要加入新的可干预变量。Agent 步骤的替代动作也只有七种固定处置,参考策略如何选择会改变策略差额与不可避免残差之间的边界。
因此,企业团队不应把 11.4 万美元当成部署收益预测,而应把变量设计当成事故分析的前置工作。在上线归因工具之前,先问系统是否记录了消息 ID、到达时间、去重状态、账本提交结果和权威状态查询,能否对这些事件做可控重放。没有这些变量,模型再擅长解释轨迹,也只能在它看得见的 Agent 动作里寻找答案;最后一步往往只是损失落地的位置,不一定是损失开始的地方。