AGI Daily
资讯日报词条论文人物新创
Rafael Rafailov · 人物 | AGIDaily
人物目录

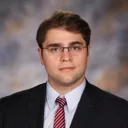
Rafael Rafailov

DPO 与 OpenVLA 共同作者,研究离线强化学习、模仿学习与语言模型偏好优化。

个人介绍

Rafael Rafailov 的研究涉及机器学习、机器人感知与控制,关注如何复用已有数据进行离线强化学习、规划和模仿学习。他曾在斯坦福大学开展计算机科学博士阶段研究,并取得统计学及计算机科学硕士学位;2024 年的 OpenVLA 项目将其署名机构列为斯坦福大学。

他参与提出直接偏好优化 DPO,通过对奖励模型重新参数化,把语言模型的偏好学习转化为直接优化的分类目标。他也共同署名 OpenVLA,参与将视觉语言预训练能力用于机器人动作学习的研究。两项工作分别讨论了语言模型行为调整和机器人策略训练。

机构与经历

  • Thinking Machines Lab

    技术团队成员

    现职(斯坦福 IRIS 实验室校友页)

  • Stanford University

    2024 年论文署名机构

    2024

公开联系方式

  • 个人学术主页

研究成果

DPO 通过改写训练目标降低偏好对齐流程的复杂度;OpenVLA 则以开放预训练策略复用机器人经验。这些工作展示了如何借助既有数据和模型能力训练新的行为。

  • OpenVLA: An Open-Source Vision-Language-Action Model

    2024

    共同作者。研究将视觉语言模型与真实机器人示范结合,训练可在新任务上微调的开源动作策略。

    暂未收录引用统计

  • Direct Preference Optimization: Your Language Model is Secretly a Reward Model

    2023

    共同作者。利用奖励与最优策略之间的关系,直接通过偏好数据和分类损失训练语言模型,简化传统 RLHF 的奖励建模与策略优化流程。

    暂未收录引用统计

参考来源

  1. 斯坦福 IRIS 实验室校友页:Thinking Machines 任职
  2. Rafael Rafailov 个人学术主页:研究经历与头像出处
  3. OpenVLA 官方项目:作者与 2024 年署名机构
  4. OpenVLA 原始论文
  5. DPO 原始论文

在文章或论文中关联此人

[Rafael Rafailov](/people/rafael-rafailov)